Pytorch训练过程出现nan的解决方式

yipeiwu_com7年前Python基础

今天使用shuffleNetV2+,使用自己的数据集,遇到了loss是nan的情况,而且top1精确率出现断崖式上升,这显示是不正常的。
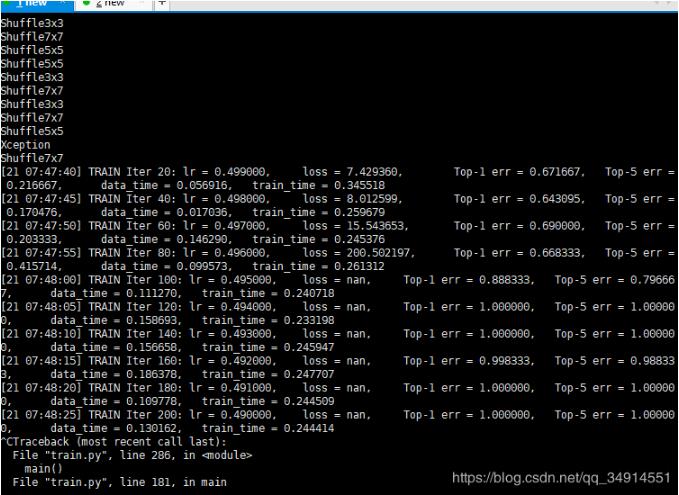
在网上查了下解决方案。我的问题是出在学习率上了。

我自己做的样本数据集比较小,就三类,每类大概三百多张,初始学习率是0.5。后来设置为0.1就解决了。

按照解决方案上写的。出现nan的情况还有以下几种:

学习率太大,但是样本数据集又很小。(我的情况)

自定义的loss除以了一个很小的数字,小到接近0。

数据不干净,数据本身就有nan,可以用numpy.isnan检查。

target,即label是大于等于0的。从1到类别数目-1变化。

以上这篇Pytorch训练过程出现nan的解决方式就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。

相关文章

在Python中操作文件之read()方法的使用教程

 read()方法读取文件size个字节大小。如果读取命中获得EOF大小字节之前,那么它只能读取可用的字节。 语法 以下是read()方法的语法: fileObject.r...

使用Django的模版来配合字符串翻译工作

Django模板使用两种模板标签,且语法格式与Python代码有些许不同。 为了使得模板访问到标签,需要将 {% load i18n %} 放在模板最前面。 这个{% trans %}模...

Atom的python插件和常用插件说明

python: simplified-chinese-menu:中文汉化(英文差的) 代码高亮:Atom自带 自动补全:autocomplete-python 语法检查:linter-f...

python读取csv和txt数据转换成向量的实例

最近写程序需要从文件中读取数据,并把读取的数据转换成向量。 查阅资料之后找到了读取csv文件和txt文件两种方式,下面结合自己的实验过程,做简要记录,供大家参考: 1、读取csv文件的数...

python3中bytes和string之间的互相转换

前言 Python 3最重要的新特性大概要算是对文本和二进制数据作了更为清晰的区分。文本总是Unicode,由str类型表示,二进制数据则由bytes类型表示。Python 3不会以任意...