python采用requests库模拟登录和抓取数据的简单示例

yipeiwu_com7年前Python爬虫

如果你还在为python的各种urllib和urlibs,cookielib 头疼,或者还还在为python模拟登录和抓取数据而抓狂,那么来看看我们推荐的requests,python采集数据模拟登录必备利器!

这也是python推荐的HTTP客户端库:

本文就以一个模拟登录的例子来加以说明,至于采集大家就请自行发挥吧。

代码很简单,主要是展现python的requests库的简单至极,代码如下:

s = requests.session()
data = {'user':'用户名','passdw':'密码'}
#post 换成登录的地址,
res=s.post('http://www.xxx.net/index.php?action=login',data);
#换成抓取的地址
s.get('http://www.xxx.net/archives/155/');

看!仅仅4行代码,即可模拟登录。
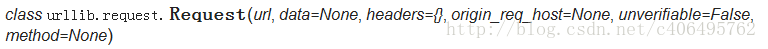
相关文章

Python3网络爬虫之使用User Agent和代理IP隐藏身份

Python3网络爬虫之使用User Agent和代理IP隐藏身份

本文介绍了Python3网络爬虫之使用User Agent和代理IP隐藏身份,分享给大家,具体如下: 运行平台:Windows Python版本:Python3.x IDE...

Python爬虫包BeautifulSoup异常处理(二)

面对网络不稳定,页面更新等问题,很可能出现程序异常的问题,所以我们要对程序进行一些异常处理。大家可能觉得处理异常是一个比较麻烦的活,但在面对复杂网页和任务的时候,无疑成为一个很好的代码习...

python爬虫爬取笔趣网小说网站过程图解

python爬虫爬取笔趣网小说网站过程图解

首先:文章用到的解析库介绍 BeautifulSoup: Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功能。 它是一个工具箱,通过解析...

python selenium爬取斗鱼所有直播房间信息过程详解

还是分析一下大体的流程: 首先还是Chrome浏览器抓包分析元素,这是网址:https://www.douyu.com/directory/all 发现所有房间的信息都是保存在一个无...

python3写爬取B站视频弹幕功能

python3写爬取B站视频弹幕功能

需要准备的环境: 一个B站账号,需要先登录,否则不能查看历史弹幕记录 联网的电脑和顺手的浏览器,我用的Chrome Python3环境以及request模块,安装使用命令,换源比较快:...