Python采集腾讯新闻实例
目标是把腾讯新闻主页上所有新闻爬取下来,获得每一篇新闻的名称、时间、来源以及正文。
接下来分解目标,一步一步地做。
步骤1:将主页上所有链接爬取出来,写到文件里。
python在获取html方面十分方便,寥寥数行代码就可以实现我们需要的功能。
page = urllib.urlopen(url)
html = page.read()
page.close()
return html
我们都知道html链接的标签是“a”,链接的属性是“href”,也就是要获得html中所有tag=a,attrs=href 值。
查阅了资料,一开始我打算用HTMLParser,而且也写出来了。但是它有一个问题,就是遇到中文字符的时候无法处理。
class parser(HTMLParser.HTMLParser):
def handle_starttag(self, tag, attrs):
if tag == 'a':
for attr, value in attrs:
if attr == 'href':
print value
后来使用了SGMLParser,它就没有这个问题。
class URLParser(SGMLParser):
def reset(self):
SGMLParser.reset(self)
self.urls = []
def start_a(self,attrs):
href = [v for k,v in attrs if k=='href']
if href:
self.urls.extend(href)
SGMLParser针对某个标签都需要重载它的函数,这里是把所有的链接放到该类的urls里。
lParser = URLParser()#分析器来的
socket = urllib.urlopen("http://news.qq.com/")#打开这个网页
fout = file('urls.txt', 'w')#要把链接写到这个文件里
lParser.feed(socket.read())#分析啦
reg = 'http://news.qq.com/a/.*'#这个是用来匹配符合条件的链接,使用正则表达式匹配
pattern = re.compile(reg)
for url in lParser.urls:#链接都存在urls里
if pattern.match(url):
fout.write(url+'\n')
fout.close()
这样子就把所有符合条件的链接都保存到urls.txt文件里了。
步骤2:对于每一个链接,获取它的网页内容。
很简单,只需要打开urls.txt文件,一行一行地读出来就可以了。
也许这里会显得多此一举,但是基于我对解耦的强烈愿望,我还是果断地写到文件里了。后面如果采用面向对象编程,重构起来是十分方便的。
获取网页内容部分也是相对简单的,但是需要把网页的内容都保存到一个文件夹里。
这里有几个新的用法:
os.getcwd()#获得当前文件夹路径
os.path.sep#当前系统路径分隔符(是这个叫法吗?)windows下是“\”,linux下是“/”
#判断文件夹是否存在,如果不存在则新建一个文件夹
if os.path.exists('newsdir') == False:
os.makedirs('newsdir')
#str()用来将某个数字转为字符串
i = 5
str(i)
有了这些方法,将字符串保存到某个文件夹下不同的文件就不再是一件困难的事了。
步骤3:枚举每一个网页,根据正则匹配获得目标数据。
下面的方法是用来遍历文件夹的。
#这个是用来遍历某个文件夹的
for parent, dirnames, filenames in os.walk(dir):
for dirname in dirnames
print parent, dirname
for filename in filenames:
print parent, filename
遍历,读取,匹配,结果就出来了。
我使用的数据提取的正则表达式是这样的:
reg = '<div class="hd">.*?<h1>(.*?)</h1>.*?<span class="pubTime">(.*?)</span>.*?<a .*?>(.*?)</a>.*?<div id="Cnt-Main-Article-QQ" .*?>(.*?)</div>'
其实这个并不能匹配到腾讯网的所有新闻,因为上面的新闻有两种格式,标签有一点差别,所以只能提取出一种。
另外一点就是通过正则表达式的提取肯定不是主流的提取方法,如果需要采集其他网站,就需要变更正则表达式,这可是一件比较麻烦的事情。
提取之后观察可知,正文部分总是会参杂一些无关信息,比如“<script>...</script>”“<p></p>”等等。所以我再通过正则表达式将正文切片。
def func(str):#谁起的这个名字
strs = re.split("<style>.*?</style>|<script.*?>.*?</script>|&#[0-9]+;|<!--\[if !IE\]>.+?<!\[endif\]-->|<.*?>", str)#各种匹配,通过“|”分隔
ans = ''
#将切分的结果组合起来
for each in strs:
ans += each
return ans
这样腾讯网上面的正文基本全部能够提取出来。
到此整个采集也就结束了。
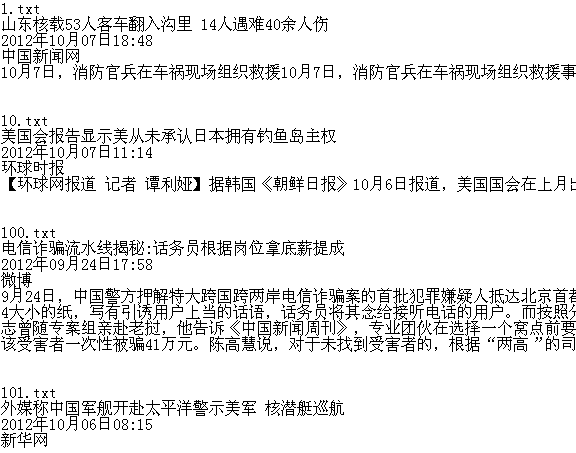
展示一下我提取到的结果(不使用自动换行,右边隐藏了):
注意:
1、打开某个网址的时候,如果网址是坏的(打不开),若不处理则会报错。我简单地使用处理异常的方式,估计应该有其他方式。
try:
socket = urllib.urlopen(url)
except:
continue
2、Python正则表达式中的“.”号,可以匹配任意字符,但是除了“\n”。
3、如何去除字符串末尾的“\n”?python的处理简直优雅到死啊!
line = line[0:-1]
