使用Python编写提取日志中的中文的脚本的方法
由于工作需要在一大堆日志里面提取相应的一些固定字符,如果单纯靠手工取提取,数据量大,劳心劳力,于是自然而然想到了用Python做一个对应的提取工具,代替手工提取的繁杂,涉及中文字符,正则表达式不好匹配,但不是不可以实现,这个以后优化时再说。
需求描述:
一个父目录中存在多个子文件夹,子文件夹下有多个txt形式化的Log日志,要求从所有地方Log日志中找出CardType=9, CardNo=0时的CardID的值,并将其统计存储到一个文本文件中,要求CardID不能够重复。
需求解析:
首先获取所有的Log日志的全路径,根据路径分别加载到将各个Log日志加载到内存中进行提取分析,并将结果存储到给定的文本文件中。
解决方案:
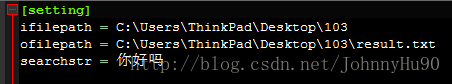
为了尽可能的简洁通用,这里使用配置文件作为输入变量的依据。不多说,上代码:
配置文件如下:
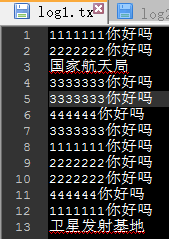
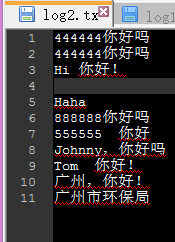
103文件夹下有两个文件:log1.txt和log2.txt, 内容类似如下:
Python代码实现如下:
# -*- coding: utf-8 -*-
#!/usr/bin/python
# filename: picktools.py
# codedtime:2015-3-25

import os
import configparser

# 遍历一个目录,输出所有文件名
def itemsbrowse(path):
  for home, dirs, files in os.walk(path):
    for filename in files:
      yield os.path.join(home, filename)

# 给的文件中查找对应的字符串所在行
def findchars(filename, chars):
  file = open(filename, 'r')
  for eachline in file:
    if eachline.find(chars) >= 0:
      yield eachline
  file.close()

# 添加到指定的文件
def addtofile(filename, mygenerator):
  file = open(filename, 'a')   # 追加方式打开
  for line in mygenerator:
    file.write(line)
  file.close()

# 过滤重复的字符行
def filter(filename):
  mylist = []
  file = open(filename, 'r')
  for eachline in file:
    mylist.append(eachline.strip())
  file.close()

  file2 = open(os.path.splitext(filename)[0] + '_filter.txt', 'w')
  for line in list(set(mylist)):
    print(line, file = file2)
    #file2.write(line)
  file2.close()


def excute():
  iniconf = configparser.ConfigParser()
  iniconf.read('config.ini')
  ifile = iniconf.get('setting', 'ifilepath')
  ofile = iniconf.get('setting', 'ofilepath')
  chars = iniconf.get('setting', 'searchstr')

  for fullname in itemsbrowse(ifile):
    mygenerator = findchars(fullname, chars)
    addtofile(ofile, mygenerator)

  filter(ofile)


if __name__ == '__main__':
  excute()
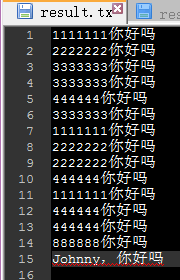
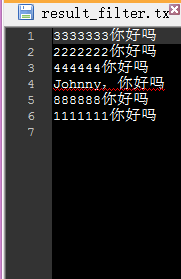
输出结果:输出两个文件result.txt 和result_filter.txt
心得体会:
1、利用Python去处理一些日常的小任务,可以很方便的完成,相比较C/C++来说,这方面生产力高了不少。
2、本文设计对中文字符的处理,所以使用正则表达式不太怎么方便,但不少不可以,后续版本中会添加对正则的支持!
3、由于初学中,所以代码写的不够精炼简洁,后续进行再优化!
