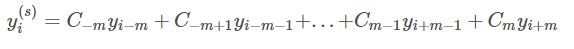python使用htmllib分析网页内容的方法

yipeiwu_com7年前Python基础

本文实例讲述了python使用htmllib分析网页内容的方法。分享给大家供大家参考。具体实现方法如下:

import htmllib, urllib, formatter, sys
website = urllib.urlopen("http://yourweb.com")
data = website.read()
website.close()
format = formatter.AbstractFormatter(formatter.DumbWriter(sys.stdout))
ptext = htmllib.HTMLParser(format)
ptext.feed(data)
ptext.close()

希望本文所述对大家的Python程序设计有所帮助。
相关文章

python2 与 pyhton3的输入语句写法小结

什么是输入 咱们在银行ATM机器前取钱时,肯定需要输入密码,对不? 那么怎样才能让程序知道咱们刚刚输入的是什么呢?? 大家应该知道了,如果要完成ATM机取钱这件事情,需要先从键盘中输入一...

Python编程中类与类的关系详解

类与类的关系 依赖关系 # 依赖关系: 将一个类的类名或者对象传给另一个类的方法中. class Elephant: def __init__(self, name):...

python字典的遍历3种方法详解

python字典的遍历3种方法详解

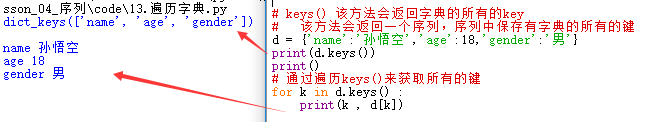
遍历字典: keys() 、values() 、items()   1. xxx.keys() : 返回字典的所有的key 返回一个序列,序列中保存有字典的所有的键   效果图:   ...

执行Django数据迁移时报 1091错误及解决方法

执行Django数据迁移时报 1091错误及解决方法

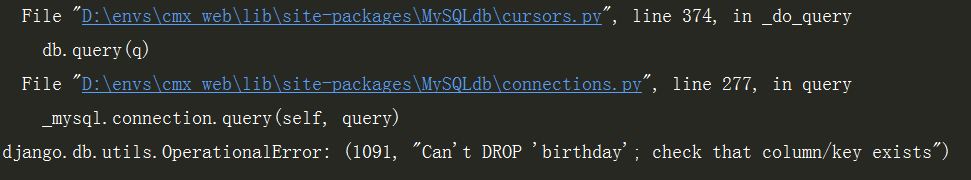
问题描述   今天在Pycharm 中的Terminal下,执行数据迁移操作时,第一步: Python manage.py makemigrations ,是没有任何问题,但就是在执行真...

Python求离散序列导数的示例

Python求离散序列导数的示例

有一组4096长度的数据,需要找到一阶导数从正到负的点,和三阶导数从负到正的点,截取了一小段。 394.0 388.0 389.0 388.0 388.0 392.0 39...