基于Python实现对PDF文件的OCR识别
最近在做一个项目的时候,需要将PDF文件作为输入,从中输出文本,然后将文本存入数据库中。为此,我找寻了很久的解决方案,最终才确定使用tesseract。所以不要浪费时间了,我们开始吧。
1.安装tesseract
在不同的系统中安装tesseract非常容易。为了简便,我们以Ubuntu为例。
在Ubuntu中你仅仅需要运行以下命令:

这将会安装支持3种不同语言的tesseract。
2.安装PyOCR
现在我们还需要安装tesseract的Python接口。幸运的是,有许多出色的Python接口。
我们采用最新的一个:

3.安装Wand和PIL
在我们开始之前,还需要另外安装两个依赖包。一个是Wand。它是Imagemagick的Python接口。
我们需要使用它来将PDF文件转换成图像:

我们也需要PIL因为PyOCR需要使用它。你可以查看官方文档以确定如何将PIL安装到你的操作系统中。
4.热身
让我们开始我们的脚本吧。首先,我们需要导入一些重要的库:

注意:我将从PIL导入的Image模块改名为PI了,因为如果不这样做的话,它将和wand.image模块发生重名冲突。
5.开始
现在我们需要获得OCR库(在本例中,即tesseract)的句柄以及我们在PyOCR中将使用的语言:

我们使用tool.get_available_languages里的第二种语言,因为之前我曾尝试过,第二种语言就是英语。
接着,我们需要建立两个列表,用于存储我们的图像和最终的文本。

下一步,我们需要采用wand将一个PDF文件转成jpeg文件。让我们试一试吧!

注意:将PDF_FILE_NAME替换成当前路径下的一个可用的PDF文件名。
wand已经将PDF中所有的独立页面都转成了独立的二进制图像对象。我们可以遍历这个大对象,并把它们加入到req_image序列中去。

现在,我们仅仅需要在图像对象上运行OCR即可,非常简单:
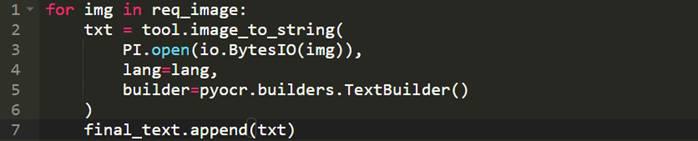
现在,所有识别出的文本已经加到了final_text序列中了。你可以任意地使用它。以上就是利用Python对PDF文件做OCR识别的全部内容,希望这个教程能够帮助到你们!
英文原文:https://pythontips.com/2016/02/25/ocr-on-pdf-files-using-python/
译者:LuCima