Python实现抓取网页生成Excel文件的方法示例
本文实例讲述了Python实现抓取网页生成Excel文件的方法。分享给大家供大家参考,具体如下:
Python抓网页,主要用到了PyQuery,这个跟jQuery用法一样,超级给力
示例代码如下:
#-*- encoding:utf-8 -*-
import sys
import locale
import string
import traceback
import datetime
import urllib2
from pyquery import PyQuery as pq
# 确定运行环境的encoding
reload(sys);
sys.setdefaultencoding('utf8');
f = open('gongsi.csv', 'w');
for i in range(1,24):
  d = pq(url="http://www.yourwebname.com/?Code=HANGYELINGYU&myFlag=allShow&SiteID=122&PageIndex=%d"%(i));
  itemsa=d('dl dt a') #取title元素
  itemsb=d('dl dd') #取title元素
  for j in range(0,len(itemsa)):
    f.write("%s,\"%s\"\n"%(itemsa[j].get('title'),itemsb[j*2].text));
  #end for
#end for
f.close();
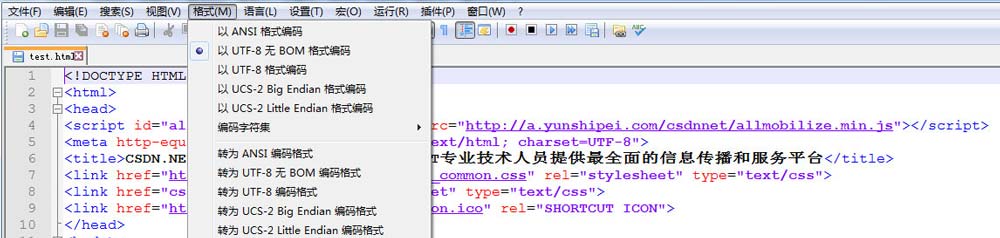
接下来就是用Notepad++打开gongsi.csv,然后转成ANSI编码格式,保存。再用Excel软件打开这个csv文件,另存为Excel文件
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python操作Excel表格技巧总结》、《Python文件与目录操作技巧汇总》、《Python文本文件操作技巧汇总》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》及《Python入门与进阶经典教程》
希望本文所述对大家Python程序设计有所帮助。