python实现简单中文词频统计示例
本文介绍了python实现简单中文词频统计示例,分享给大家,具体如下:
任务
简单统计一个小说中哪些个汉字出现的频率最高
知识点
1.文件操作
2.字典
3.排序
4.lambda
代码
import codecs
import matplotlib.pyplot as plt
from pylab import mpl
mpl.rcParams['font.sans-serif'] = ['FangSong'] # 指定默认字体
mpl.rcParams['axes.unicode_minus'] = False # 解决保存图像是负号'-'显示为方块的问题

word = []
counter = {}

with codecs.open('data.txt') as fr:
 for line in fr:
  line = line.strip()
  if len(line) == 0:
   continue
  for w in line:
   if not w in word:
    word.append(w)
   if not w in counter:
    counter[w] = 0
   else:
    counter[w] += 1

counter_list = sorted(counter.items(), key=lambda x: x[1], reverse=True)

print(counter_list[:50])

label = list(map(lambda x: x[0], counter_list[:50]))
value = list(map(lambda y: y[1], counter_list[:50]))

plt.bar(range(len(value)), value, tick_label=label)
plt.show()
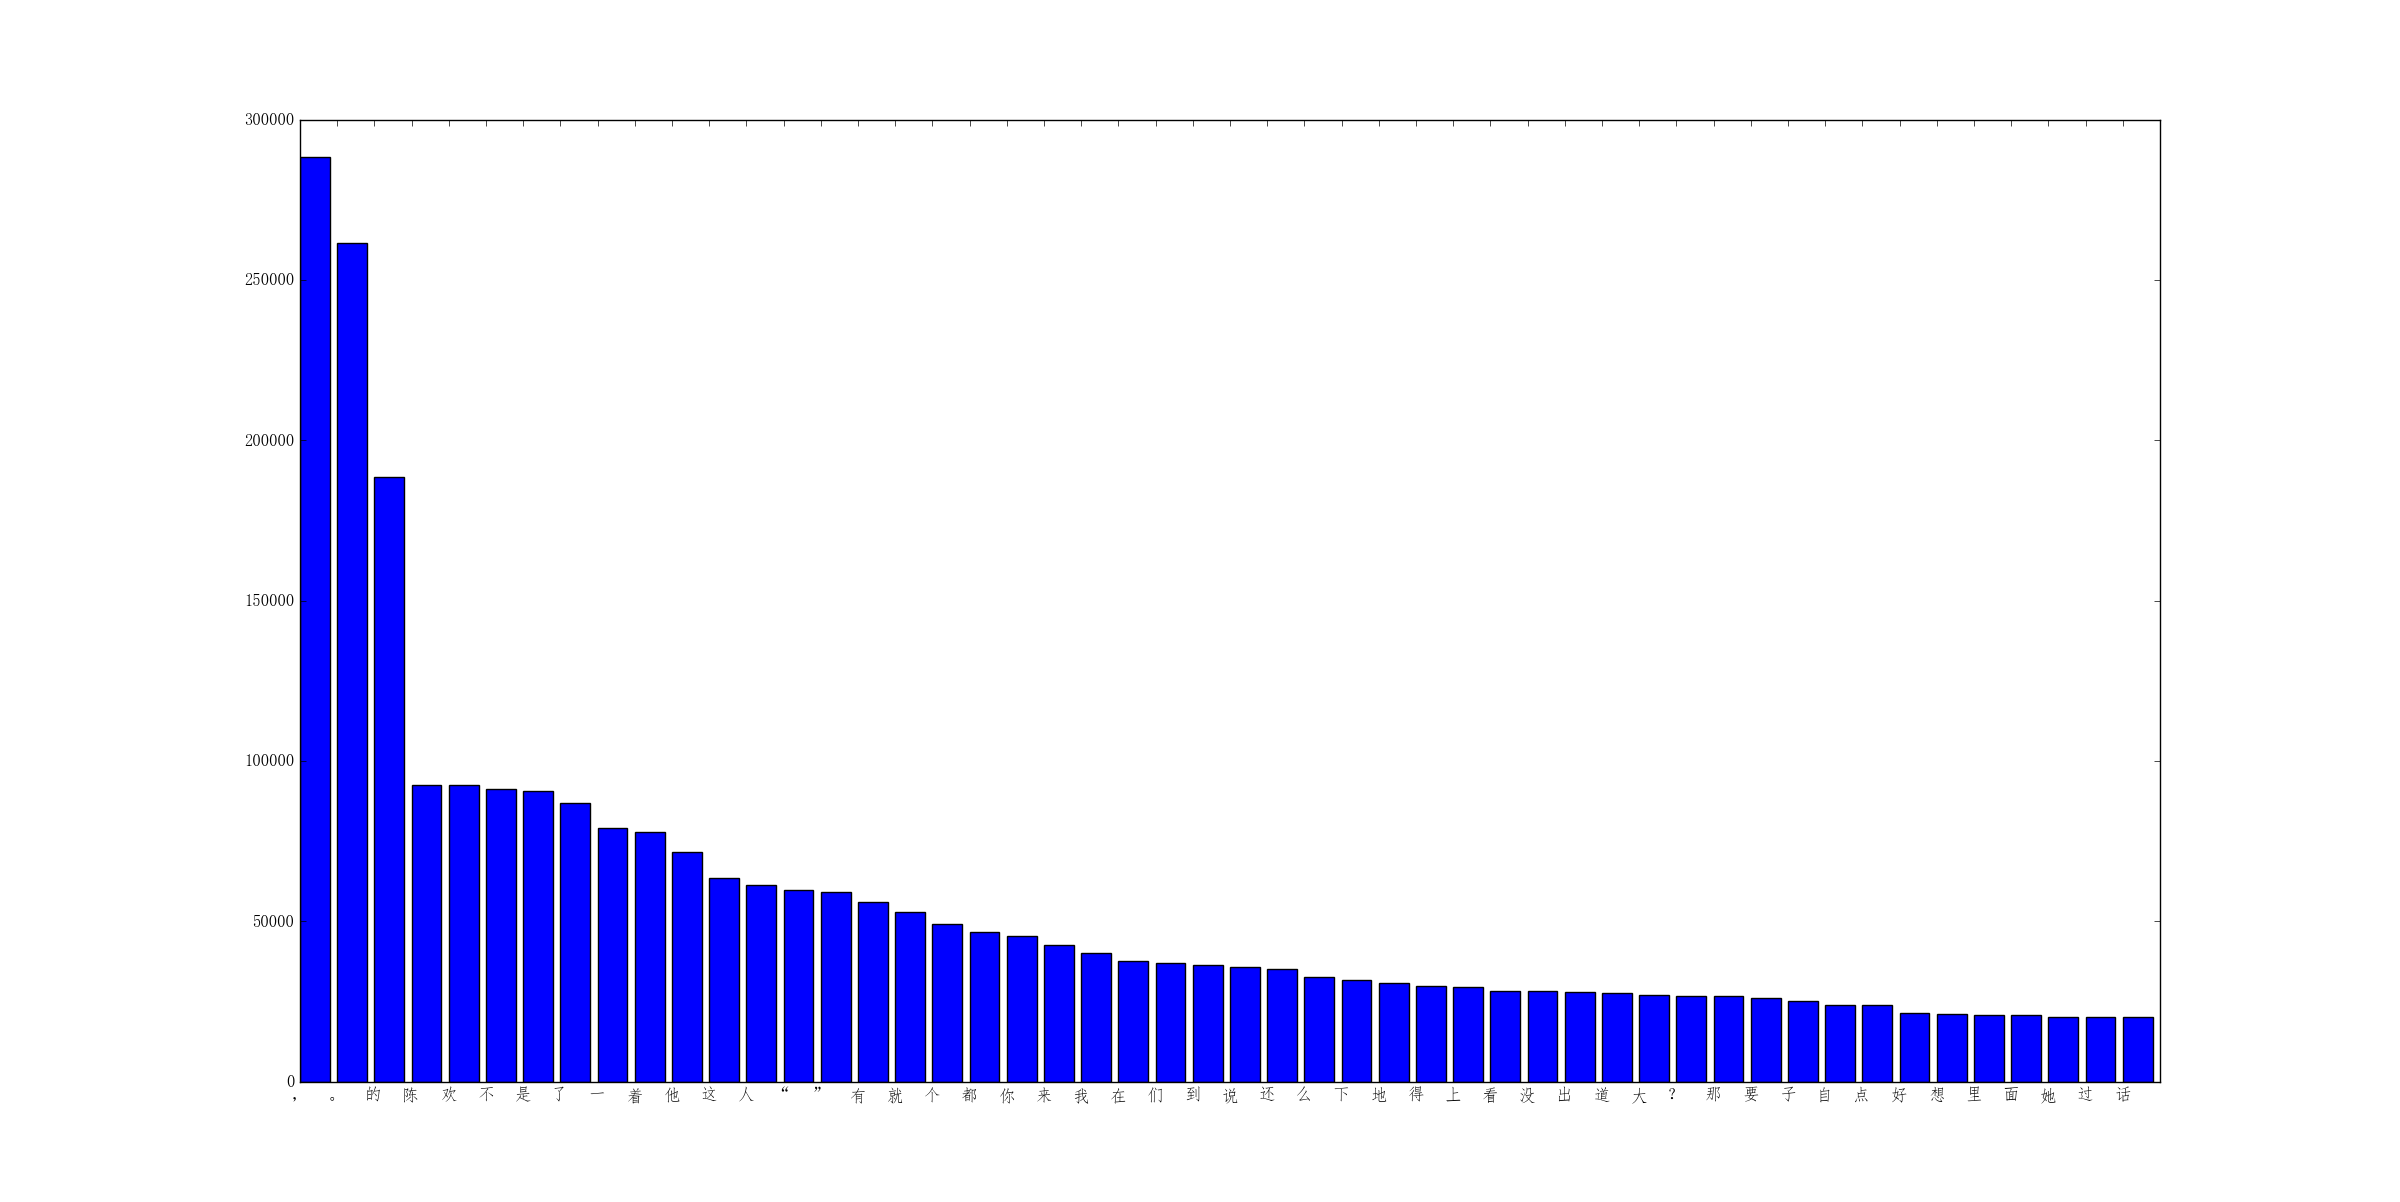
统计了一个11M的小说,结果如下:
[(',', 288508), ('。', 261584), ('的', 188693), ('陈', 92565), ('欢', 92505), ('不', 91234), ('是', 90562), ('了', 86931), ('一', 79059), ('着', 77997), ('他'
, 71695), ('这', 63580), ('人', 61210), ('“', 59719), ('”', 59115), ('有', 56054), ('就', 52862), ('个', 49097), ('都', 46850), ('你', 45400), ('来', 42659),
('我', 40057), ('在', 37676), ('们', 36966), ('到', 36351), ('说', 35828), ('还', 35260), ('么', 32601), ('下', 31742), ('地', 30692), ('得', 29904), ('上', 2
9627), ('看', 28408), ('没', 28333), ('出', 27937), ('道', 27732), ('大', 27012), ('?', 26729), ('那', 26589), ('要', 26076), ('子', 25035), ('自', 24012), ('
点', 23942), ('好', 21345), ('想', 21242), ('里', 20915), ('面', 20661), ('她', 20313), ('过', 20304), ('话', 20110)]
使用jieba先对中文文档进行分词处理
import sys
reload(sys)
sys.setdefaultencoding("utf-8")

import jieba
import jieba.analyse

wf = open('clean_title.txt','w+')
for line in open('/root/clean_data/clean_data.csv'):

  item = line.strip('\n\r').split('\t') //制表格切分
  # print item[1]
  tags = jieba.analyse.extract_tags(item[1]) //jieba分词
  tagsw = ",".join(tags) //逗号连接切分的词
  wf.write(tagsw)

wf.close()
输出的clean_title.txt内容
邮轮,地中海,深度,罗马,自由纳西,柏林签证,步行,三天,批准申根,手把手,签证,申请,如何赞爆,法兰,穿越,葡萄酒,风景,河谷,世界欧洲颜色,一种,国家,一个水族箱,帕劳,七日,上帝奥林匹亚,跑步圣托,
里尼,文明古国,探访,爱琴海,魅力,希腊
2、统计词频
#!/usr/bin/python
# -*- coding:utf-8 -*-

word_lst = []
word_dict= {}
with open('/root/clean_data/clean_title.txt') as wf,open("word.txt",'w') as wf2: //打开文件

  for word in wf:
    word_lst.append(word.split(',')) //使用逗号进行切分
    for item in word_lst:
       for item2 in item:
        if item2 not in word_dict: //统计数量
          word_dict[item2] = 1
        else:
          word_dict[item2] += 1

  for key in word_dict:
    print key,word_dict[key]
    wf2.write(key+' '+str(word_dict[key])+'\n') //写入文档
结果:
最后 4
欧洲幽蓝 1
集美 1
葡萄牙法多 1
工地 1
知道湖光山色 1
神圣 7
欧洲少女瑞士加游 1
根据词汇数量排序查看:
cat word.txt |sort -nr -k 2|more
神圣 7
最后 4
欧洲幽蓝 1
集美 1
葡萄牙法多 1
工地 1
知道湖光山色 1
欧洲少女瑞士加游 1
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。