Python数据分析之双色球中蓝红球分析统计示例
本文实例讲述了Python数据分析之双色球中蓝红球分析统计。分享给大家供大家参考,具体如下:
这里接着上一篇Python数据分析之获取双色球历史信息收集的数据处理下,
newdata.txt数据样子
...
2005-08-21, 05,10,23,27,28,30,15
2005-08-18, 04,05,17,18,26,33,04
2005-08-16, 09,12,18,21,28,29,05
...
一、蓝球统计:
analyze_data_lan.py
#!/usr/bin/python
# -*- coding:UTF-8 -*-
#调用pandas numpy matplotlib包
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
#读取newdata.txt文件
df = pd.read_table('newdata.txt',header=None,sep=',')
# print df
# print df[1:3]  #第2到第3行(索引0开始为第一行,1代表第二行,不包含第四行)
# print df.loc[0:10,:]  #第1行到第9行的全部列
# print df.loc[:,[0,7]] #全部行的第1和第8列
tdate = sorted(df.loc[:,0])   #取第一列数据
# print tdate
tdate1 = []  #将tdate数据读取到列表中
for i in tdate:
  tdate1.append(i)
print tdate1
# s = pd.Series(tdate1, index=tdate1)
s = pd.Series(range(1,len(tdate1)+1), index=tdate1)  #将日期转换为对应的数值从1开始
# print s
tblue = list(reversed(df.loc[:,7]))  #对数据取反
print tblue
fenzu = pd.value_counts(tblue,ascending=False)  #将数据进行分组统计,按照统计数降序排序
print fenzu
x=list(fenzu.index[:])  #获取蓝色号码
y=list(fenzu.values[:])  #获得蓝色统计数量
print x
print y
# print type(fenzu)
plt.figure(figsize=(10,6),dpi=70)  #配置画图大小、和细度
plt.legend(loc='best')
# plt.plot(fenzu,color='red')  #线图
plt.bar(x,y,alpha=.5, color='b',width=0.8)  #直方图参数设置
plt.title('The blue ball number')  #标题
plt.xlabel('blue number')  #x轴内容
plt.ylabel('times')  #y轴内容
plt.show()  #显示图
结果输出:
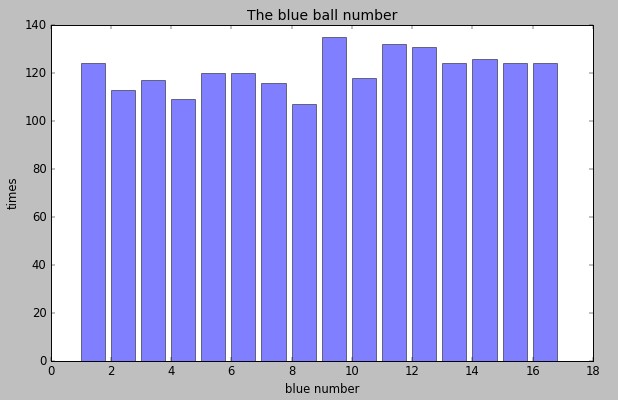
看来蓝球9选中最多
二、红球统计
analyze_data_hong.py
#!/usr/bin/python
# -*- coding:UTF-8 -*-
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
#读取文件
df = pd.read_table('newdata.txt',header=None,sep=',')
# print df
# print df[1:3]
# print df.loc[0:10,:]
# print df.loc[:,1:6]
tdate = sorted(df.loc[:,0])
# print tdate
h1 = df.loc[:,1]
h2 = df.loc[:,2]
h3 = df.loc[:,3]
h4 = df.loc[:,4]
h5 = df.loc[:,5]
h6 = df.loc[:,6]
#将数据合并到一起
all = h1.append(h2).append(h3).append(h4).append(h5).append(h6)
alldata = list(all)
print len(alldata)
fenzu = pd.value_counts(all,ascending=False)
print fenzu
x=list(fenzu.index[:])
y=list(fenzu.values[:])
print x
print y
# print type(fenzu)
plt.figure(figsize=(10,6),dpi=70)
plt.legend(loc='best',)
# plt.plot(fenzu,color='red')
plt.bar(x,y,alpha=.5, color='r',width=0.8)
plt.title('The red ball number')
plt.xlabel('red number')
plt.ylabel('times')
plt.show()
结果输出:

红球1、7、14、17、26选中几率高些
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python数学运算技巧总结》、《Python字符串操作技巧汇总》、《Python编码操作技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。