python jieba分词并统计词频后输出结果到Excel和txt文档方法
前两天,班上同学写论文,需要将很多篇论文题目按照中文的习惯分词并统计每个词出现的频率。
让我帮她实现这个功能,我在网上查了之后发现jieba这个库还挺不错的。
运行环境:
- 安装python2.7.13:https://www.python.org/downloads/release/python-2713/
- 安装jieba:pip install jieba
- 安装xlwt:pip install xlwt
具体代码如下:
#!/usr/bin/python
# -*- coding:utf-8 -*-

import sys
reload(sys)

sys.setdefaultencoding('utf-8')

import jieba
import jieba.analyse
import xlwt #写入Excel表的库

if __name__=="__main__":

 wbk = xlwt.Workbook(encoding = 'ascii')
 sheet = wbk.add_sheet("wordCount")#Excel单元格名字
 word_lst = []
 key_list=[]
 for line in open('1.txt'):#1.txt是需要分词统计的文档

  item = line.strip('\n\r').split('\t') #制表格切分
  # print item
  tags = jieba.analyse.extract_tags(item[0]) #jieba分词
  for t in tags:
   word_lst.append(t)

 word_dict= {}
 with open("wordCount.txt",'w') as wf2: #打开文件

  for item in word_lst:
   if item not in word_dict: #统计数量
    word_dict[item] = 1
   else:
    word_dict[item] += 1

  orderList=list(word_dict.values())
  orderList.sort(reverse=True)
  # print orderList
  for i in range(len(orderList)):
   for key in word_dict:
    if word_dict[key]==orderList[i]:
     wf2.write(key+' '+str(word_dict[key])+'\n') #写入txt文档
     key_list.append(key)
     word_dict[key]=0


 for i in range(len(key_list)):
  sheet.write(i, 1, label = orderList[i])
  sheet.write(i, 0, label = key_list[i])
 wbk.save('wordCount.xls') #保存为 wordCount.xls文件
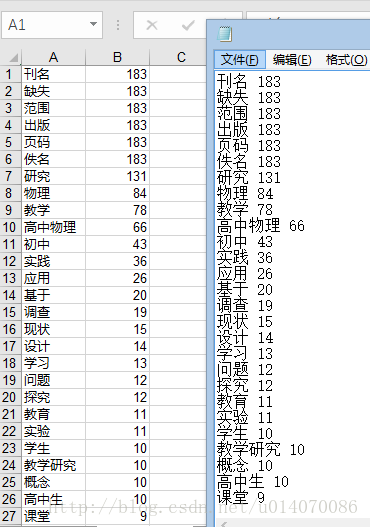
1.txt是你需要分词统计的文本内容,最后会生成wordCount.txt和wordCount.xls两个文件。下图是最后结果
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。