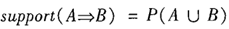python实现朴素贝叶斯分类器
本文用的是sciki-learn库的iris数据集进行测试。用的模型也是最简单的,就是用贝叶斯定理P(A|B) = P(B|A)*P(A)/P(B),计算每个类别在样本中概率(代码中是pLabel变量)
以及每个类下每个特征的概率(代码中是pNum变量)。
写得比较粗糙,对于某个类下没有此特征的情况采用p=1/样本数量。
有什么错误有人发现麻烦提出,谢谢。
[python] view plain copy
# -*- coding:utf-8 -*-
from numpy import *
from sklearn import datasets
import numpy as np

class NaiveBayesClassifier(object):

  def __init__(self):
    self.dataMat = list()
    self.labelMat = list()
    self.pLabel = {}
    self.pNum = {}

  def loadDataSet(self):
    iris = datasets.load_iris()
    self.dataMat = iris.data
    self.labelMat = iris.target
    labelSet = set(iris.target)
    labelList = [i for i in labelSet]
    labelNum = len(labelList)
    for i in range(labelNum):
      self.pLabel.setdefault(labelList[i])
      self.pLabel[labelList[i]] = np.sum(self.labelMat==labelList[i])/float(len(self.labelMat))

  def seperateByClass(self):
    seperated = {}
    for i in range(len(self.dataMat)):
      vector = self.dataMat[i]
      if self.labelMat[i] not in seperated:
        seperated[self.labelMat[i]] = []
      seperated[self.labelMat[i]].append(vector)
    return seperated

  # 通过numpy array二维数组来获取每一维每种数的概率
  def getProbByArray(self, data):
    prob = {}
    for i in range(len(data[0])):
      if i not in prob:
        prob[i] = {}
      dataSetList = list(set(data[:, i]))
      for j in dataSetList:
        if j not in prob[i]:
          prob[i][j] = 0
        prob[i][j] = np.sum(data[:, i] == j) / float(len(data[:, i]))
    prob[0] = [1 / float(len(data[:,0]))] # 防止feature不存在的情况
    return prob

  def train(self):
    featureNum = len(self.dataMat[0])
    seperated = self.seperateByClass()
    t_pNum = {} # 存储每个类别下每个特征每种情况出现的概率
    for label, data in seperated.iteritems():
      if label not in t_pNum:
        t_pNum[label] = {}
      t_pNum[label] = self.getProbByArray(np.array(data))
    self.pNum = t_pNum

  def classify(self, data):
    label = 0
    pTest = np.ones(3)
    for i in self.pLabel:
      for j in self.pNum[i]:
        if data[j] not in self.pNum[i][j]:
          pTest[i] *= self.pNum[i][0][0]
        else:
          pTest[i] *= self.pNum[i][j][data[j]]
    pMax = np.max(pTest)
    ind = np.where(pTest == pMax)
    return ind[0][0]

  def test(self):
    self.loadDataSet()
    self.train()
    pred = []
    right = 0
    for d in self.dataMat:
      pred.append(self.classify(d))
    for i in range(len(self.labelMat)):
      if pred[i] == self.labelMat[i]:
        right += 1
    print right / float(len(self.labelMat))

if __name__ == '__main__':
  NB = NaiveBayesClassifier()
  NB.test()
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。