Python实现合并excel表格的方法分析
本文实例讲述了Python实现合并excel表格的方法。分享给大家供大家参考,具体如下:
需求
将一个文件夹中的excel表格合并成我们想要的形式,主要要pandas中的concat()函数
思路
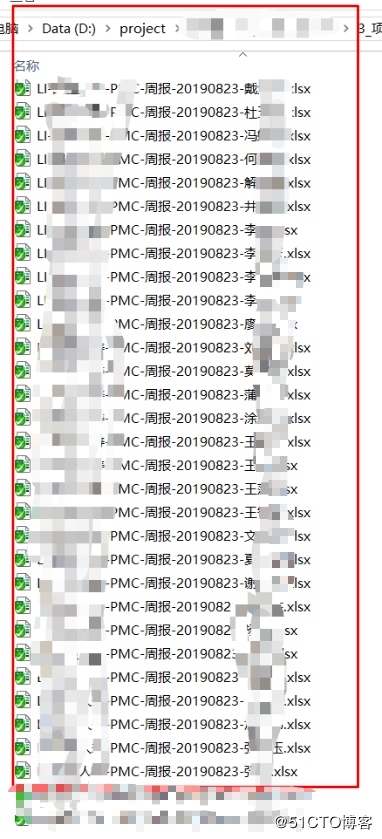
用os库将所需要处理的表格放到同一个列表中,然后遍历列表,依次把所有文件纵向连接起来。
最开始的第一种思路是先拿一个文件出来,然后让这个文件依次去和列表中的剩余文件合并;
第二种是用文件夹中第一个文件和剩余的文件合并,使用range(1,len(file)),可以省去单独取第一个文件的步骤。
遇到的问题
读取
好久没写过这个了,竟然在读取的时候出了很多错误,花了很多时间,下面按时间顺序小结一下
因为之前看到有人直接在pd.read_excel()后面操作,不需要像我以前一样分开操作
#以前的操作方式,需要占用三行
df = pd.read_excel(r'C:.\1.xlsx', sheet_name = '设备检测_空调伴侣')
temp_columns = ['','']
df_1 = df[temp_columns].dropna()
#但我在进阶的过程中,格式弄错了,导致一直报错
df = pd.read_excel(r'C:.\1.xlsx', sheet_name = '设备检测_空调伴侣').[['采集时间']['功率E(W)']]
>>>df = pd.read_excel(r'C:.\1.xlsx', sheet_name = '设备检测_空调伴侣').[['采集时间']['功率E(W)']] ^
SyntaxError: invalid syntax
#发现多了个“.”,用pd读取的excel已经是dataframe的格式了,提取直接用列表的方式就行,加“.”是表示用pd中的函数,完全不同,修正后,再运行,又报错。。。
df = pd.read_excel(r'C:.\1.xlsx', sheet_name = '设备检测_空调伴侣')[['采集时间']['功率E(W)']]
>>>TypeError: list indices must be integers or slices, not str
#发现列表中的子列表元素间忘记用“,”分隔了,修正,再运行
df = pd.read_excel(r'C:.\1.xlsx', sheet_name = '设备检测_空调伴侣')[['采集时间'],['功率E(W)']]
>>>TypeError: unhashable type: 'list'
#说实话,当时心态有点崩,但还是仔细找了找原因,报错,列表是不可拆分的类型。再对比以前的代码,才发现问题所在。
df = pd.read_excel(r'C:.\1.xlsx', sheet_name = '设备检测_空调伴侣')[['采集时间','功率E(W)']]
需要用双层列表,外面那层是用于读取dataframe,里面那层是索引的集合
完整代码
思路1:
# -*- coding: utf-8 -*-
import numpy as np
import pandas as pd
import os
#改变当前的路径
os.chdir(r'C:\Users\hao\Desktop\重写数据整理\源数据')
#将当前目录下的文件以列表的形式存放
file = os.listdir("./")
df_0 = pd.read_excel(r'C:\Users\hao\Desktop\重写数据整理\143NNCZ01_M_2017-06.xlsx', sheet_name = '设备检测_空调伴侣')[['采集时间','功率E(W)']].dropna()
#print(df_0) #df_0是第一个,依次和循环里面的每一个表做纵向连接
for aa,excel in enumerate(file) :  #enumerate 遍历,aa 返回序列,便于计数和监视
  print('当前正在处理的文件:',excel)
  df_1 = pd.read_excel(excel, sheet_name = '设备检测_空调伴侣')[['采集时间','功率E(W)']].dropna()
  #print(df_1)
  df_0 = pd.concat([df_0,df_1],ignore_index=True, axis=0)
  #print(df_0)
df_0.to_excel(r'C:\Users\hao\Desktop\output3.xlsx', index=None)
思路二:
# -*- coding: utf-8 -*-
import numpy as np
import pandas as pd
import os
#改变当前的路径
os.chdir(r'C:\Users\hao\Desktop\重写数据整理\源数据')
#将当前目录下的文件以列表的形式存放
file = os.listdir("./")
df_0 = pd.read_excel(file[0], sheet_name = '设备检测_空调伴侣')[['采集时间','功率E(W)']].dropna()
#print(df_0) #df_0是第一个,依次和循环里面的每一个表做纵向连接
for i in range(1,len(file)) :  #enumerate 遍历,aa 返回序列,便于计数和监视
  print('当前正在处理的文件:',file[i],'第{}/{}个'.format(i+1,len(file)+1))
  df_1 = pd.read_excel(file[i], sheet_name = '设备检测_空调伴侣')[['采集时间','功率E(W)']].dropna()
  #print(df_1)
  df_0 = pd.concat([df_0,df_1],ignore_index=True, axis=0)
  #print(df_0)
df_0.to_excel(r'C:\Users\hao\Desktop\output5.xlsx', index=None)
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python操作Excel表格技巧总结》、《Python文件与目录操作技巧汇总》、《Python文本文件操作技巧汇总》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》及《Python入门与进阶经典教程》
希望本文所述对大家Python程序设计有所帮助。