python处理“&#”开头加数字的html字符方法

yipeiwu_com7年前Python基础

python如何处理“&#”开头加数字的html字符,比如:风水这类数据。

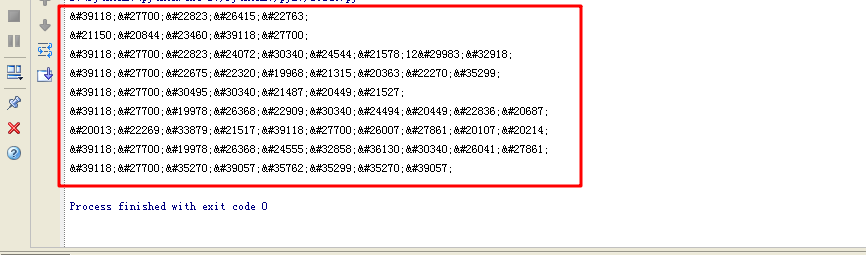
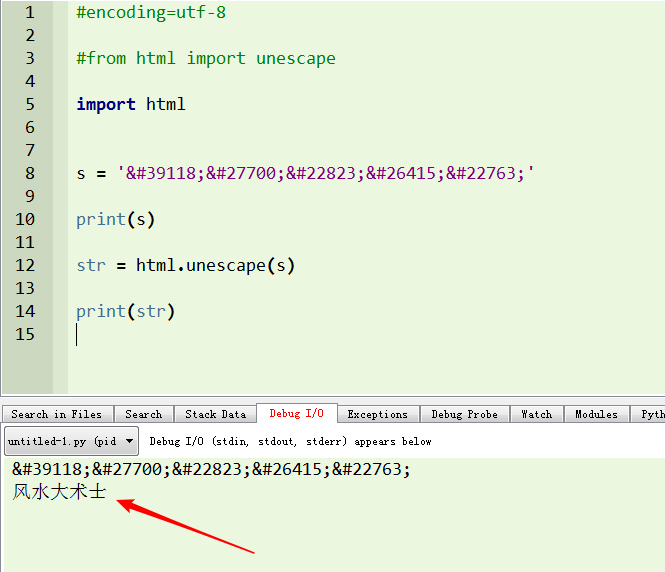
用python抓取数据时,有时会遇到想要数据是以“&#”开头加数字的字符,比如图中所示的这些:

风水大术士
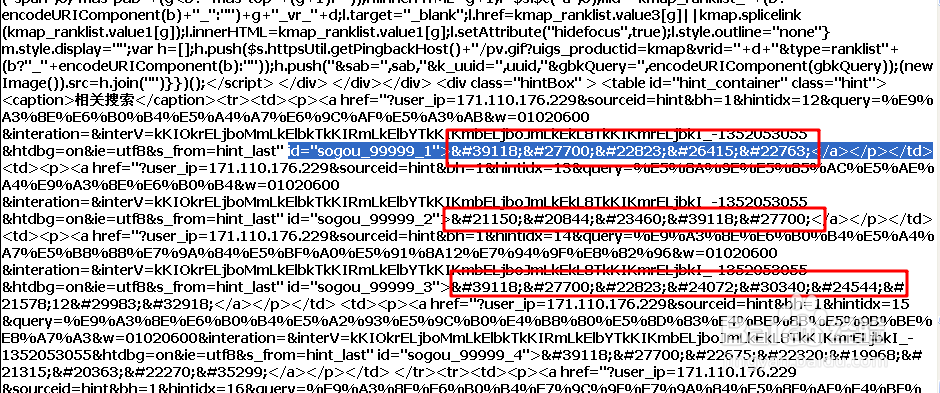
这些字符需要再次转换才能变回中文内容。这些字符需要再次转换才能变回中文内容。

Python2.7版本

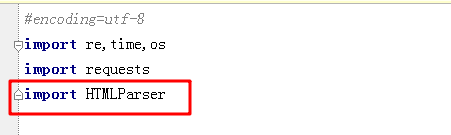
在python2.7版本中,使用import HTMLParser
定义变量,再定义转换代码。
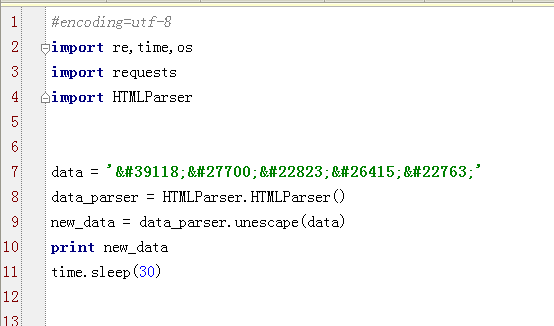
代码中最重要的是“data_parser = HTMLParser.HTMLParser()”,通过此才能用“.unescape()”方法。 
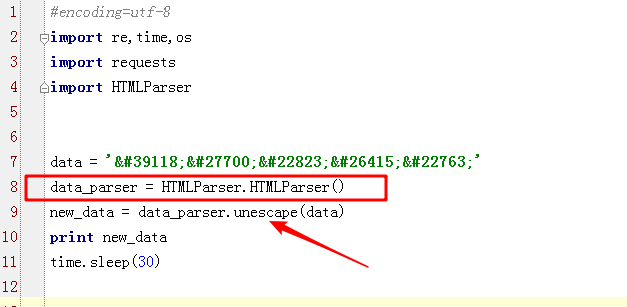
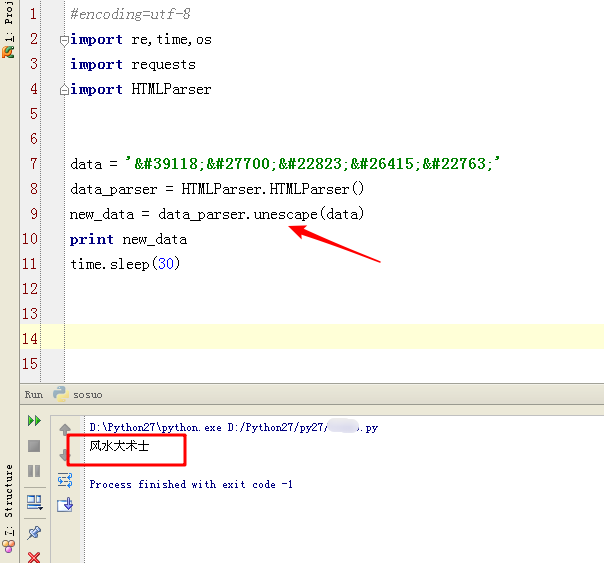
测试运行,这串字符串正常输出了中文。
Python3.7+版本

在最新python版本中,不能用上面的导入方法。可以用"import html"或者“from html import unescape”。这里使用"import html"做测试。
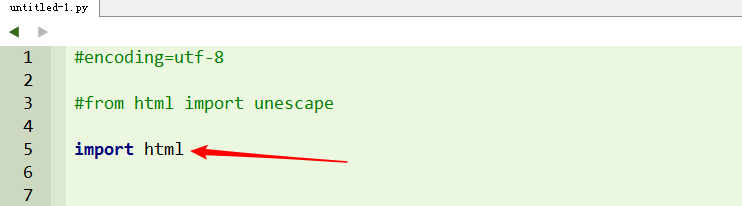
导入html后,直接用".unescape()"来处理字符串。
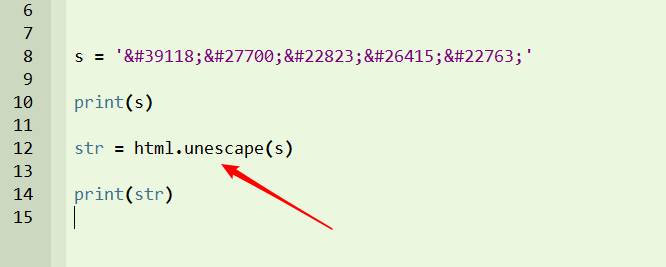
运行后,正常转换成了中文字符。
感谢大家的阅读和对【听图阁-专注于Python设计】的支持。
相关文章

Python中文竖排显示的方法

本文实例讲述了Python中文竖排显示的方法。分享给大家供大家参考。具体如下: 这里将中文竖排显示 比如 衣食者人之生利也,然且犹尚有节,葬埋者人之死利也,夫何独无节於此乎 输出为: 衣...

详解python单例模式与metaclass

单例模式的实现方式 将类实例绑定到类变量上 class Singleton(object): _instance = None def __new__(cls, *args...

pandas.DataFrame删除/选取含有特定数值的行或列实例

pandas.DataFrame删除/选取含有特定数值的行或列实例

1.删除/选取某列含有特殊数值的行 import pandas as pd import numpy as np a=np.array([[1,2,3],[4,5,6],[7,8...

Python解析并读取PDF文件内容的方法

Python解析并读取PDF文件内容的方法

本文实例讲述了Python解析并读取PDF文件内容的方法。分享给大家供大家参考,具体如下: 一、问题描述 利用python,去读取pdf文本内容。 二、效果 三、运行环境 pytho...

利用Fn.py库在Python中进行函数式编程

尽管Python事实上并不是一门纯函数式编程语言,但它本身是一门多范型语言,并给了你足够的自由利用函数式编程的便利。函数式风格有着各种理论与实际上的好处(你可以在Python的文档中找到...