详解pytorch 0.4.0迁移指南
总说
由于pytorch 0.4版本更新实在太大了, 以前版本的代码必须有一定程度的更新. 主要的更新在于 Variable和Tensor的合并., 当然还有Windows的支持, 其他一些就是支持scalar tensor以及修复bug和提升性能吧. Variable和Tensor的合并导致以前的代码会出错, 所以需要迁移, 其实迁移代价并不大.
Tensor和Variable的合并
说是合并, 其实是按照以前(0.1-0.3版本)的观点是: Tensor现在默认requires_grad=False的Variable了.torch.Tensor和torch.autograd.Variable现在其实是同一个类! 没有本质的区别! 所以也就是说,现在已经没有纯粹的Tensor了, 是个Tensor, 它就支持自动求导!你现在要不要给Tensor包一下Variable, 都没有任何意义了.
查看Tensor的类型
使用.isinstance()或是x.type(), 用type()不能看tensor的具体类型.
>>> x = torch.DoubleTensor([1, 1, 1])
>>> print(type(x)) # was torch.DoubleTensor
"<class 'torch.Tensor'>"
>>> print(x.type()) # OK: 'torch.DoubleTensor'
'torch.DoubleTensor'
>>> print(isinstance(x, torch.DoubleTensor)) # OK: True
True
requires_grad 已经是Tensor的一个属性了
>>> x = torch.ones(1)
>>> x.requires_grad #默认是False
False
>>> y = torch.ones(1)
>>> z = x + y
>>> # 显然z的该属性也是False
>>> z.requires_grad
False
>>> # 所有变量都不需要grad, 所以会出错
>>> z.backward()
RuntimeError: element 0 of tensors does not require grad and does not have a grad_fn
>>>
>>> # 可以将`requires_grad`作为一个参数, 构造tensor
>>> w = torch.ones(1, requires_grad=True)
>>> w.requires_grad
True
>>> total = w + z
>>> total.requires_grad
True
>>> # 现在可以backward了
>>> total.backward()
>>> w.grad
tensor([ 1.])
>>> # x,y,z都是不需要梯度的,他们的grad也没有计算
>>> z.grad == x.grad == y.grad == None
True
通过.requires_grad()来进行使得Tensor需要梯度.
不要随便用.data
以前.data是为了拿到Variable中的Tensor,但是后来, 两个都合并了. 所以.data返回一个新的requires_grad=False的Tensor!然而新的这个Tensor与以前那个Tensor是共享内存的. 所以不安全, 因为
y = x.data # x需要进行autograd
# y和x是共享内存的,但是这里y已经不需要grad了,
# 所以会导致本来需要计算梯度的x也没有梯度可以计算.从而x不会得到更新!
所以, 推荐用x.detach(), 这个仍旧是共享内存的, 也是使得y的requires_grad为False,但是,如果x需要求导, 仍旧是可以自动求导的!
scalar的支持
这个非常重要啊!以前indexing一个一维Tensor,返回的是一个number类型,但是indexing一个Variable确实返回一个size为(1,)的vector.再比如一些reduction操作, 比如tensor.sum()返回一个number, 但是variable.sum()返回的是一个size为(1,)的vector.
scalar是0-维度的Tensor, 所以我们不能简单的用以前的方法创建, 我们用一个torch.tensor注意,是小写的!
y = x.data # x需要进行autograd
# y和x是共享内存的,但是这里y已经不需要grad了,
# 所以会导致本来需要计算梯度的x也没有梯度可以计算.从而x不会得到更新!
从上面例子可以看出, 通过引入scalar, 可以将返回值的类型进行统一.
重点:
1. 取得一个tensor的值(返回number), 用.item()
2. 创建scalar的话,需要用torch.tensor(number)
3.torch.tensor(list)也可以进行创建tensor
累加loss
以前了累加loss(为了看loss的大小)一般是用total_loss+=loss.data[0], 比较诡异的是, 为啥是.data[0]? 这是因为, 这是因为loss是一个Variable, 所以以后累加loss, 用loss.item().
这个是必须的, 如果直接加, 那么随着训练的进行, 会导致后来的loss具有非常大的graph, 可能会超内存. 然而total_loss只是用来看的, 所以没必要进行维持这个graph!
弃用volatile
现在这个flag已经没用了. 被替换成torch.no_grad(),torch.set_grad_enable(grad_mode)等函数
>>> x = torch.zeros(1, requires_grad=True)
>>> with torch.no_grad():
...   y = x * 2
>>> y.requires_grad
False
>>>
>>> is_train = False
>>> with torch.set_grad_enabled(is_train):
...   y = x * 2
>>> y.requires_grad
False
>>> torch.set_grad_enabled(True) # this can also be used as a function
>>> y = x * 2
>>> y.requires_grad
True
>>> torch.set_grad_enabled(False)
>>> y = x * 2
>>> y.requires_grad
False
dypes,devices以及numpy-style的构造函数
dtype是data types, 对应关系如下:
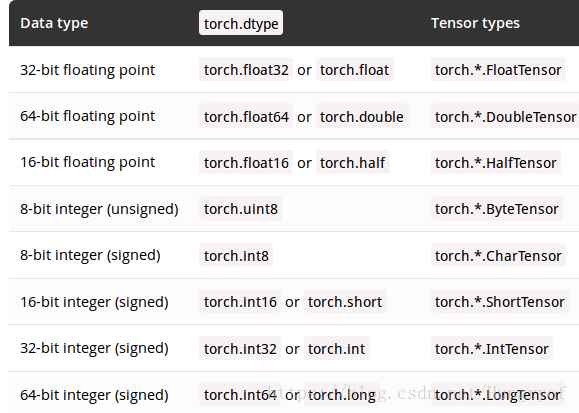
通过.dtype可以得到
其他就是以前写device type都是用.cup()或是.cuda(), 现在独立成一个函数, 我们可以
>>> device = torch.device("cuda:1")
>>> x = torch.randn(3, 3, dtype=torch.float64, device=device)
tensor([[-0.6344, 0.8562, -1.2758],
    [ 0.8414, 1.7962, 1.0589],
    [-0.1369, -1.0462, -0.4373]], dtype=torch.float64, device='cuda:1')
>>> x.requires_grad # default is False
False
>>> x = torch.zeros(3, requires_grad=True)
>>> x.requires_grad
True
新的创建Tensor方法
主要是可以指定dtype以及device.
>>> device = torch.device("cuda:1")
>>> x = torch.randn(3, 3, dtype=torch.float64, device=device)
tensor([[-0.6344, 0.8562, -1.2758],
    [ 0.8414, 1.7962, 1.0589],
    [-0.1369, -1.0462, -0.4373]], dtype=torch.float64, device='cuda:1')
>>> x.requires_grad # default is False
False
>>> x = torch.zeros(3, requires_grad=True)
>>> x.requires_grad
True
用 torch.tensor来创建Tensor
这个等价于numpy.array,用途:
1.将python list的数据用来创建Tensor
2. 创建scalar
# 从列表中, 创建tensor
>>> cuda = torch.device("cuda")
>>> torch.tensor([[1], [2], [3]], dtype=torch.half, device=cuda)
tensor([[ 1],
    [ 2],
    [ 3]], device='cuda:0')

>>> torch.tensor(1)        # 创建scalar
tensor(1)
torch.*like以及torch.new_*
第一个是可以创建, shape相同, 数据类型相同.
 >>> x = torch.randn(3, dtype=torch.float64)
 >>> torch.zeros_like(x)
 tensor([ 0., 0., 0.], dtype=torch.float64)
 >>> torch.zeros_like(x, dtype=torch.int)
 tensor([ 0, 0, 0], dtype=torch.int32)
当然如果是单纯想要得到属性与前者相同的Tensor, 但是shape不想要一致:
>>> x = torch.randn(3, dtype=torch.float64)
 >>> x.new_ones(2) # 属性一致
 tensor([ 1., 1.], dtype=torch.float64)
 >>> x.new_ones(4, dtype=torch.int)
 tensor([ 1, 1, 1, 1], dtype=torch.int32)
书写 device-agnostic 的代码
这个含义是, 不要显示的指定是gpu, cpu之类的. 利用.to()来执行.
# at beginning of the script
device = torch.device("cuda:0" if torch.cuda.is_available() else "cpu")

...

# then whenever you get a new Tensor or Module
# this won't copy if they are already on the desired device
input = data.to(device)
model = MyModule(...).to(device)
迁移代码对比
以前的写法
model = MyRNN()
 if use_cuda:
   model = model.cuda()

 # train
 total_loss = 0
 for input, target in train_loader:
   input, target = Variable(input), Variable(target)
   hidden = Variable(torch.zeros(*h_shape)) # init hidden
   if use_cuda:
     input, target, hidden = input.cuda(), target.cuda(), hidden.cuda()
   ... # get loss and optimize
   total_loss += loss.data[0]

 # evaluate
 for input, target in test_loader:
   input = Variable(input, volatile=True)
   if use_cuda:
     ...
   ...
现在的写法
 # torch.device object used throughout this script
 device = torch.device("cuda" if use_cuda else "cpu")

 model = MyRNN().to(device)

 # train
 total_loss = 0
 for input, target in train_loader:
   input, target = input.to(device), target.to(device)
   hidden = input.new_zeros(*h_shape) # has the same device & dtype as `input`
   ... # get loss and optimize
   total_loss += loss.item()      # get Python number from 1-element Tensor

 # evaluate
 with torch.no_grad():          # operations inside don't track history
   for input, target in test_loader:
     ...
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。