python接口调用已训练好的caffe模型测试分类方法
训练好了model后,可以通过python调用caffe的模型,然后进行模型测试的输出。
本次测试主要依靠的模型是在caffe模型里面自带训练好的结构参数:~/caffe/models/bvlc_reference_caffenet/bvlc_reference_caffenet.caffemodel,以及结构参数
:~/caffe/models/bvlc_reference_caffenet/deploy.prototxt相结合,用python接口进行调用。
训练的源代码以及相应的注释如下所示:
# -*- coding: UTF-8 -*-
import os
import caffe
import numpy as np
root='/home/zf/caffe/'#指定根目录
deploy=root+'models/bvlc_reference_caffenet/deploy.prototxt'#结构文件
caffe_model=root + 'models/bvlc_reference_caffenet/bvlc_reference_caffenet.caffemodel'
#已经训练好的model

dir =root+'examples/images/'#保存测试图片的集合
filelist=[]
filenames=os.listdir(dir)
for fn in filenames:
  fullfilename = os.path.join(dir,fn)
  filelist.append(fullfilename)
#filelist.append(fn)
def Test(img):
#加载模型
  net = caffe.Net(deploy,caffe_model,caffe.TEST)

# 加载输入和配置预处理
  transformer = caffe.io.Transformer({'data':net.blobs['data'].data.shape})
  transformer.set_mean('data', np.load('/home/zf/caffe/python/caffe/imagenet/ilsvrc_2012_mean.npy').mean(1).mean(1))
  transformer.set_transpose('data', (2,0,1))
  transformer.set_channel_swap('data', (2,1,0))
  transformer.set_raw_scale('data', 255.0)

#注意可以调节预处理批次的大小
#由于是处理一张图片,所以把原来的10张的批次改为1
  net.blobs['data'].reshape(1,3,227,227)

#加载图片到数据层
  im = caffe.io.load_image(img)
  net.blobs['data'].data[...] = transformer.preprocess('data', im)

#前向计算
  out = net.forward()

# 其他可能的形式 : out = net.forward_all(data=np.asarray([transformer.preprocess('data', im)]))

#预测分类
  print out['prob'].argmax()

#打印预测标签
  labels = np.loadtxt("/home/zf/caffe/data/ilsvrc12/synset_words.txt", str, delimiter='\t')
  top_k = net.blobs['prob'].data[0].flatten().argsort()[-1]
  print 'the class is:',labels[top_k]
  f=file("/home/zhengfeng/caffe/examples/zf/label.txt","a")
  f.writelines(img+' '+labels[top_k]+'\n')
labels_filename=root +'data/ilsvrc12/synset_words.txt'
#循环遍历文件夹root+'examples/images/'下的所有图片
for i in range(0,len(filelist)):
  img=filelist[i]
  Test(img)
ps:主要有以下的文件需要说明
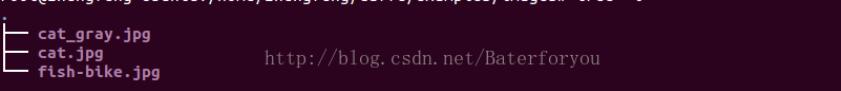
待测试的文件夹里面的图片数据为:
最后的输出结果如下:
以下是本人定义的label.txt文件写入的预测的数据:

如果在编译的时候出现import caffe error的话,说明没有导入caffe
Export PYTHONPATH=$PYTHONPATH:/home/zf/caffe/python,如果还是不行,可能是你的caffe的python接口未编译,cd /home/zf/caffe,然后执行make pycaffe,接着再测试。
以上这篇python接口调用已训练好的caffe模型测试分类方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。