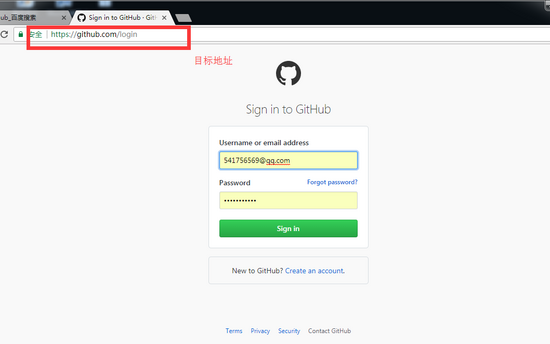
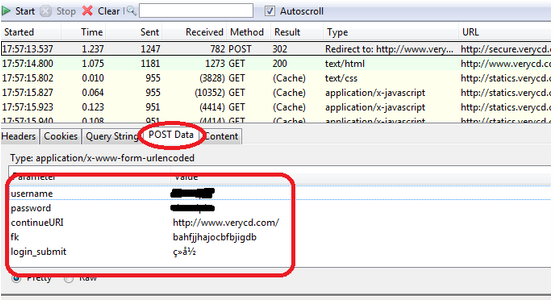
python 自动提交和抓取网页
下面是用python写的,使用lxml来做html分析,从网上看到的,说是分析速度最快的哦,不过没有验证过。好了,上代码。
import urllib
import urllib2
import urlparse
import lxml.html
def url_with_query(url, values):
parts = urlparse.urlparse(url)
rest, (query, frag) = parts[:-2], parts[-2:]
return urlparse.urlunparse(rest + (urllib.urlencode(values), None))
def make_open_http():
opener = urllib2.build_opener(urllib2.HTTPCookieProcessor())
opener.addheaders = [] # pretend we're a human -- don't do this
def open_http(method, url, values={}):
if method == "POST":
return opener.open(url, urllib.urlencode(values))
else:
return opener.open(url_with_query(url, values))
return open_http
open_http = make_open_http()
tree = lxml.html.fromstring(open_http("GET", "//www.jb51.net").read())
form = tree.forms[0]
form.fields["q"] = "eplussoft"
form.action="//www.jb51.net/search"
response = lxml.html.submit_form(form,open_http=open_http)
html = response.read()
doc = lxml.html.fromstring(html)
lxml.html.open_in_browser(doc)
恩,验证码是个大问题。还有今天看了一些百度贴吧上的东西,更是坏了心情,它的验证码是用ajax取的图片,这就更加麻烦了。不过好像现在大多数的论坛和博客的验证码都是这样的了。这样第一次抓取下来的页面就不会包含有验证码图片了,更不要说分析验证码图片了。要解决的问题还是很多的。。。
复制代码 代码如下:
import urllib
import urllib2
import urlparse
import lxml.html
def url_with_query(url, values):
parts = urlparse.urlparse(url)
rest, (query, frag) = parts[:-2], parts[-2:]
return urlparse.urlunparse(rest + (urllib.urlencode(values), None))
def make_open_http():
opener = urllib2.build_opener(urllib2.HTTPCookieProcessor())
opener.addheaders = [] # pretend we're a human -- don't do this
def open_http(method, url, values={}):
if method == "POST":
return opener.open(url, urllib.urlencode(values))
else:
return opener.open(url_with_query(url, values))
return open_http
open_http = make_open_http()
tree = lxml.html.fromstring(open_http("GET", "//www.jb51.net").read())
form = tree.forms[0]
form.fields["q"] = "eplussoft"
form.action="//www.jb51.net/search"
response = lxml.html.submit_form(form,open_http=open_http)
html = response.read()
doc = lxml.html.fromstring(html)
lxml.html.open_in_browser(doc)
恩,验证码是个大问题。还有今天看了一些百度贴吧上的东西,更是坏了心情,它的验证码是用ajax取的图片,这就更加麻烦了。不过好像现在大多数的论坛和博客的验证码都是这样的了。这样第一次抓取下来的页面就不会包含有验证码图片了,更不要说分析验证码图片了。要解决的问题还是很多的。。。