python实现从web抓取文档的方法

yipeiwu_com7年前Python爬虫

本文实例讲述了Python实现从Web的一个URL中抓取文档的方法,分享给大家供大家参考。具体方法分析如下:

实例代码如下:

import urllib 
doc = urllib.urlopen("http://www.python.org").read() 
print doc#直接打印出网页 
def reporthook(*a): 
 print a 
#将http://www.renren.com网页保存到renre.html中,
#每读取一个块调用一字reporthook函数 
 
urllib.urlretrieve("http://www.renren.com",'renren.html',reporthook) 
#将http://www.renren.com网页保存到renre.html中 
urllib.urlretrieve("http://www.renren.com",'renren.html')

程序运行结果如下:

<!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd">
..........................网页内容
</body>
</html>


(0, 8192, -1)
(1, 8192, -1)
(2, 8192, -1)

其中urllib.urlopen返回一个类文件对象。

希望本文所述对大家的Python程序设计有所帮助。
相关文章

Python爬虫动态ip代理防止被封的方法

Python爬虫动态ip代理防止被封的方法

在爬取的过程中难免发生ip被封和403错误等等,这都是网站检测出你是爬虫而进行反爬措施,在这里为大家总结一下怎么用IP代理防止被封 首先,设置等待时间: 常见的设置等待时间有两种,一种是...

Python爬取成语接龙类网站

Python爬取成语接龙类网站

介绍 本文将展示如何利用Python爬虫来实现诗歌接龙。 该项目的思路如下: 利用爬虫爬取诗歌,制作诗歌语料库; 将诗歌分句,形成字典:键(key)为该句首字的拼音,值(value)为...

python抓取搜狗微信公众号文章

python抓取搜狗微信公众号文章

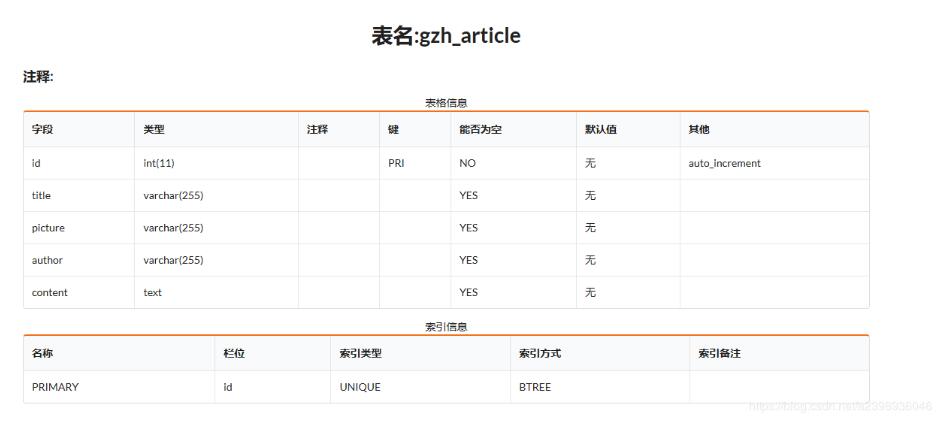
初学python,抓取搜狗微信公众号文章存入mysql mysql表: 代码: import requests import json import re import pymy...

用python3 urllib破解有道翻译反爬虫机制详解

用python3 urllib破解有道翻译反爬虫机制详解

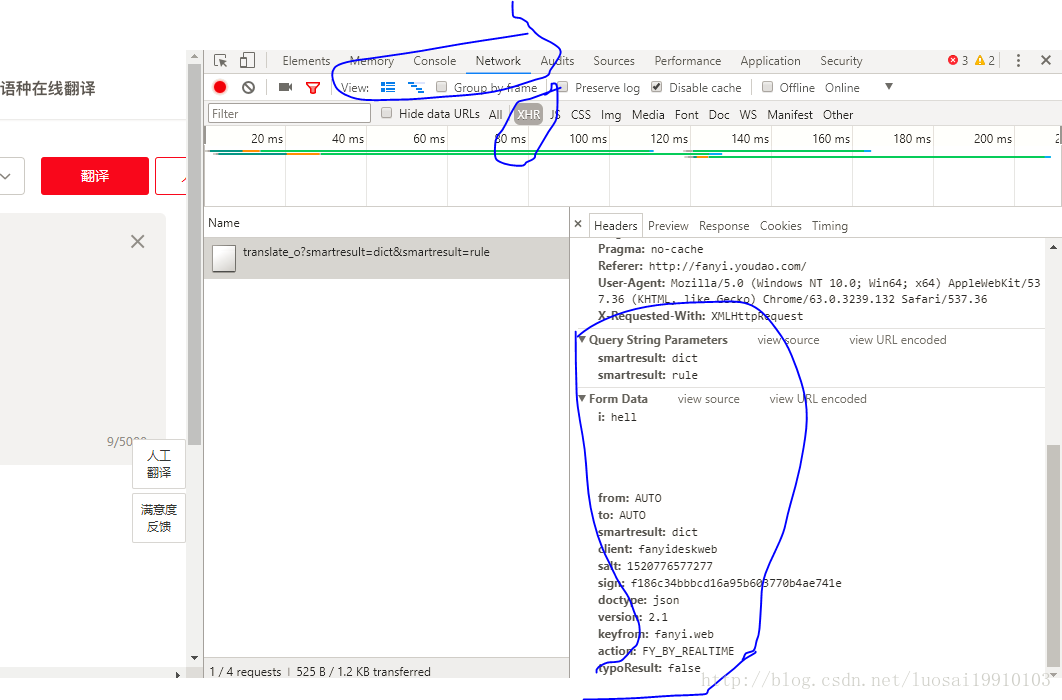
前言 最近在学习python 爬虫方面的知识,网上有一博客专栏专门写爬虫方面的,看到用urllib请求有道翻译接口获取翻译结果。发现接口变化很大,用md5加了密,于是自己开始破解。加上...

Python网络爬虫中的同步与异步示例详解

Python网络爬虫中的同步与异步示例详解

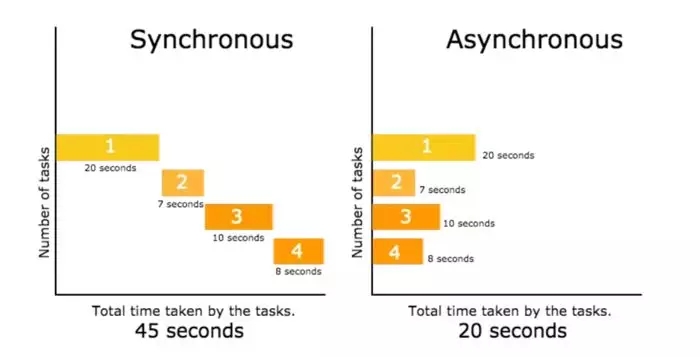
一、同步与异步 #同步编程(同一时间只能做一件事,做完了才能做下一件事情) <-a_url-><-b_url-><-c_url-> #异步编程...