零基础写python爬虫之打包生成exe文件

yipeiwu_com7年前Python爬虫

1.下载pyinstaller并解压(可以去官网下载最新版):
https://github.com/pyinstaller/pyinstaller/

2.下载pywin32并安装(注意版本,我的是python2.7):
https://pypi.python.org/pypi/pywin32

3.将项目文件放到pyinstaller文件夹下面(我的是baidu.py):
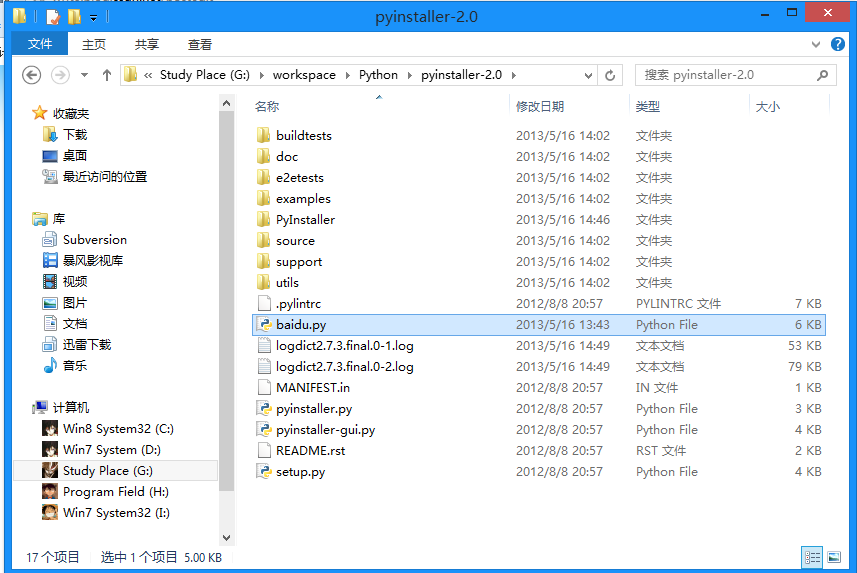
4.按住shift键右击,在当前路径打开命令提示行,输入以下内容(最后的是文件名):
python pyinstaller.py -F baidu.py

5.生成的exe文件,在baidu文件夹下的dist文件夹中,双击即可运行:


相关文章

python定向爬虫校园论坛帖子信息

引言 写这个小爬虫主要是为了爬校园论坛上的实习信息,主要采用了Requests库 源码 URLs.py 主要功能是根据一个初始url(包含page页面参数)来获得page页面从当前页面数...

Python的爬虫程序编写框架Scrapy入门学习教程

Python的爬虫程序编写框架Scrapy入门学习教程

1. Scrapy简介 Scrapy是一个为了爬取网站数据,提取结构性数据而编写的应用框架。 可以应用在包括数据挖掘,信息处理或存储历史数据等一系列的程序中。 其最初是为了页面抓取 (更...

python&MongoDB爬取图书馆借阅记录

python&MongoDB爬取图书馆借阅记录

直接上需求和代码 首先是需要爬取的链接和网页:http://211.81.31.34/uhtbin/cgisirsi/x/0/0/57/49?user_id=LIBSCI_ENGI&pa...

用python爬取租房网站信息的代码

自己在刚学习python时写的,中途遇到很多问题,查了很多资料,下面就是我爬取租房信息的代码: 链家的房租网站 两个导入的包 1.requests 用来过去网页内容 2.Beaut...

Python爬虫包BeautifulSoup实例(三)

一步一步构建一个爬虫实例,抓取糗事百科的段子 先不用beautifulsoup包来进行解析 第一步,访问网址并抓取源码 # -*- coding: utf-8 -*- # @Auth...