用Python程序抓取网页的HTML信息的一个小实例
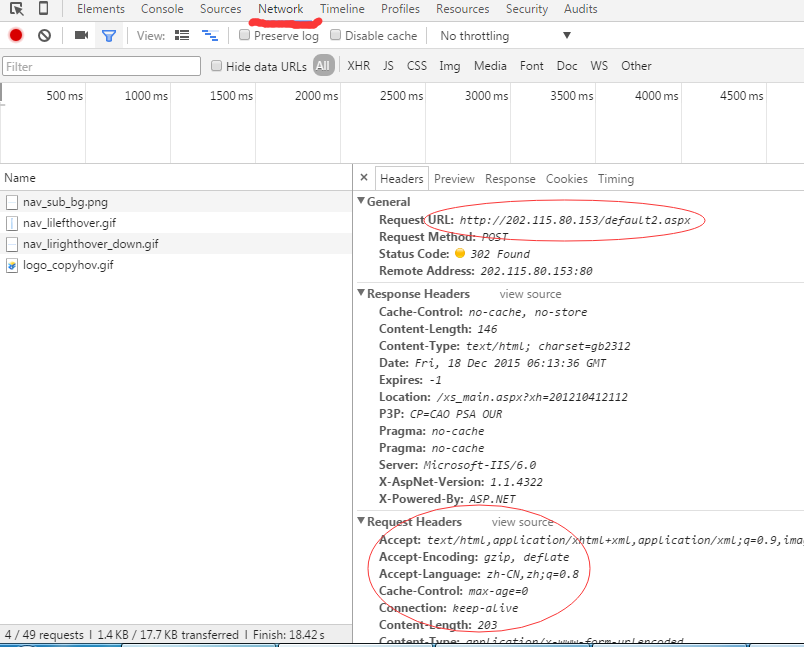
抓取网页数据的思路有好多种,一般有:直接代码请求http、模拟浏览器请求数据(通常需要登录验证)、控制浏览器实现数据抓取等。这篇不考虑复杂情况,放一个读取简单网页数据的小例子:
目标数据
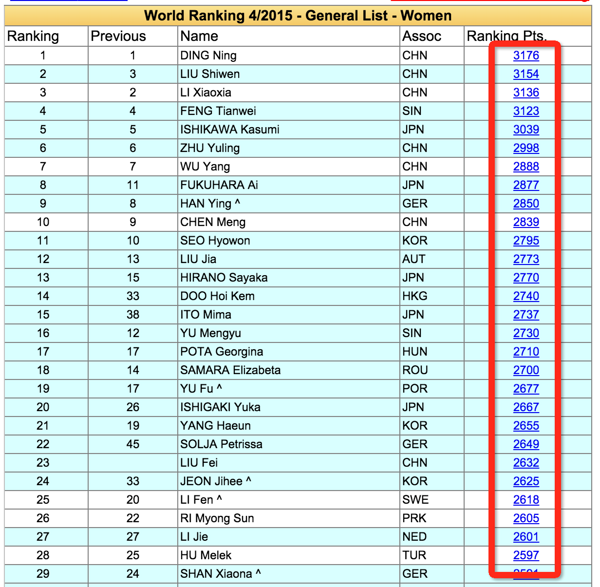
将ittf网站上这个页面上所有这些选手的超链接保存下来。
数据请求
真的很喜欢符合人类思维的库,比如requests,如果是要直接拿网页文本,一句话搞定:
doc = requests.get(url).text
解析html获得数据
以beautifulsoup为例,包含获取标签、链接,以及根据html层次结构遍历等方法。参考见这里。下面这个片段,从ittf网站上获取指定页面上指定位置的链接。
url = 'http://www.ittf.com/ittf_ranking/WR_Table_3_A2.asp?Age_category_1=&Age_category_2=&Age_category_3=&Age_category_4=&Age_category_5=&Category=100W&Cont=&Country=&Gender=W&Month1=4&Year1=2015&s_Player_Name=&Formv_WR_Table_3_Page='+str(page)
doc = requests.get(url).text
soup = BeautifulSoup(doc)
atags = soup.find_all('a')
rank_link_pre = 'http://www.ittf.com/ittf_ranking/'

mlfile = open(linkfile,'a')
for atag in atags:
  #print atag
  if atag!=None and atag.get('href') != None:
    if "WR_Table_3_A2_Details.asp" in atag['href']:
      link = rank_link_pre + atag['href']
      links.append(link)
      mlfile.write(link+'\n')
      print 'fetch link: '+link
mlfile.close()