在windows下快速搭建web.py开发框架方法
用Python进行web开发的话有很多框架供选择,比如最出名的Django,tornado等,除了这些框架之外,有一个轻量级的框架使用起来也是非常方便和顺手,就是web.py。它由一名黑客所创建,但是不幸的是这位创建者于2013年自杀了。据说现在由另外一个人在维护和更新。现在就来了解一下windows下如何搭建web.py开发环境。
一.安装web.py
在 https://github.com/webpy/webpy上下载web.py安装包。注意github对浏览器版本有要求的,比如不支持IE9以下的。
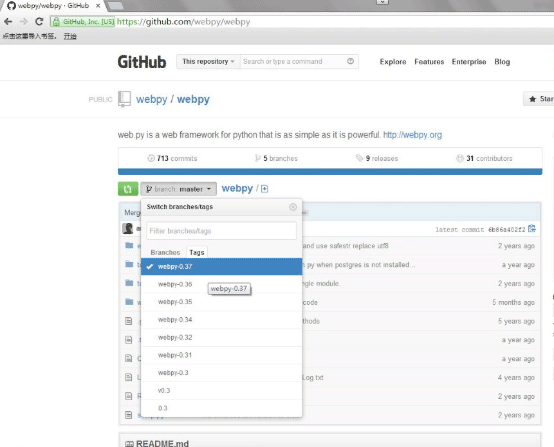
自己根据需要下载相应的版本。
下载下来之后,解压,打开cmd,cd到解压目录下,输入
python setup.py install
安装完成即可。(前提必须要安装python,python3以下版本)
二.测试程序。
建立一个hello.py文件
import web
urls = ('/hello', 'hello',
)
class hello(object):
def GET(self):
return 'hello world'
if __name__ == "__main__":
app = web.application(urls, globals())
app.run()
urls是url映射规则(类似于servlet中的映射),类hello是链接请求响应。
然后在命令行下运行该文件:

如果要停止该程序Ctrl+C就可以退出。默认程序运行在8080端口,然后在浏览器里输入:http://127.0.0.1:8080/hello,就可以看到结果了:

程序默认运行在8080端口,而如果8080端口被其他程序占用的话,web.py程序会运行失败,比如会出现sockets.error这种错误,此时需要更改端口:


注意web.py并不具备部署网站的能力,因此对于web.py程序只能在本地访问,如果要进行部署必须要使用apache或者nginx。