深入理解python中的浅拷贝和深拷贝
在讲什么是深浅拷贝之前,我们先来看这样一个现象:
a = ['scolia', 123, [], ]
b = a[:]
b[2].append(666)
print a
print b
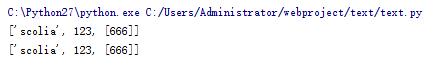
为什么我只对b进行修改,却影响到了a呢?看过我在之前的文章中就说过:序列中保存的都是内存的引用。
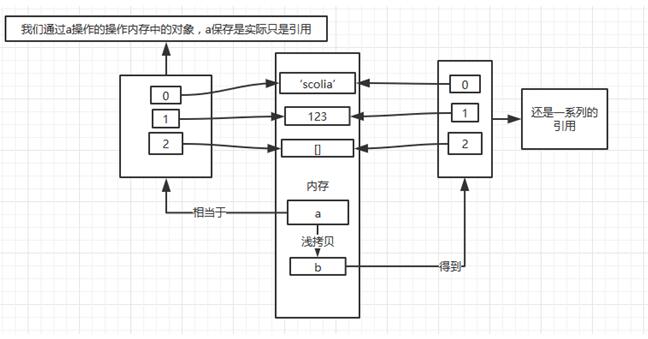
所以,当我们通过b去修改里面的空列表的时候,其实就是修改内存中的同一个对象,所以会影响到a。
a = ['scolia', 123, [], ]
b = a[:]
print id(a), id(a[0]), id(a[1]), id(a[2])
print id(b), id(b[0]), id(b[1]), id(b[2])
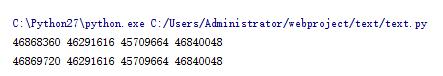
代码验证无误,所以虽然a和b是两个不同的对象,但是里面的引用都是一样的。这就是所谓新的对象,旧的内容。
但是,浅拷贝还不仅如此,看下面:
a = ['scolia', 123, [], ]
b = a[:]
b[1] = 666
print a
print b
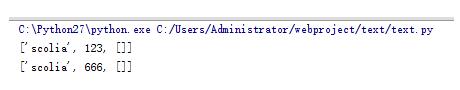
这又是怎么回事呢?
看过我在python变量赋值说明的同学会知道:对于字符串、数字等不可变的数据类型,修改就相当于重新赋值。在这里就相当于刷新引用。
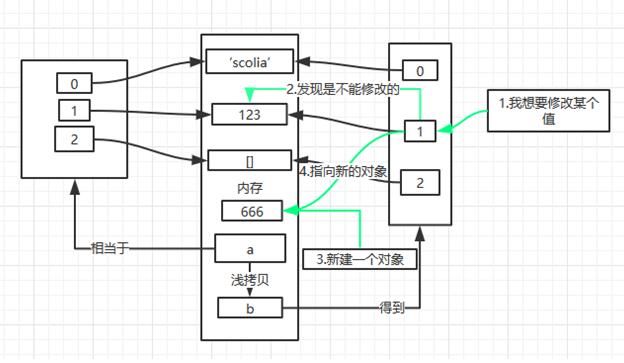
代码验证一下:
a = ['scolia', 123, [], ]
b = a[:]
b[1] = 666
print id(a), id(a[0]), id(a[1]), id(a[2])
print id(b), id(b[0]), id(b[1]), id(b[2])
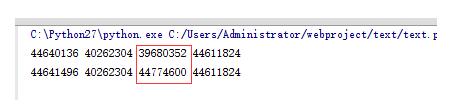
看来是正确的。
上面讲的这些就是浅拷贝,总结起来,浅拷贝只是拷贝了一系列引用,当我们在拷贝出来的对象对可修改的数据类型进行修改的时候,并没有改变引用,所以会影响原对象。而对不可修改的对象进行修改的是,则是新建了对象,刷新了引用,所以和原对象的引用不同,结果也就不同。
创建浅拷贝的方法:
1.切片操作
2.使用list()工厂函数新建对象。( b = list(a) )
那么深拷贝不就是将里面引用的对象重新创建了一遍并生成了一个新的一系列引用。
基本上是这样的,但是对于字符串、数字等不可修改的对象来说,重新创建一份似乎有点浪费内存,反正你到时要修改的时候都是新建对象,刷新引用的。所以还用原来的引用也无所谓,还能达到节省内存的目的。
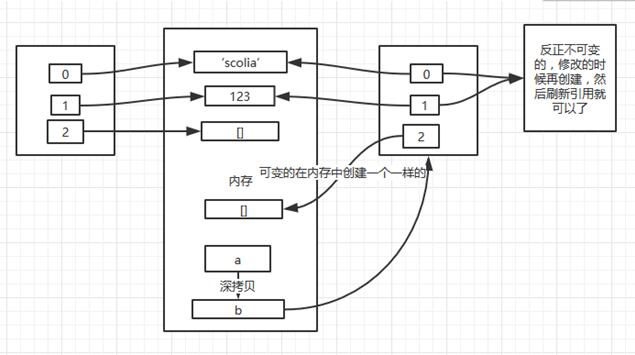
看下代码验证:
from copy import deepcopy
a = ['scolia', 123, [], ]
b = deepcopy(a)
b[1] = 666
print id(a), id(a[0]), id(a[1]), id(a[2])
print id(b), id(b[0]), id(b[1]), id(b[2])
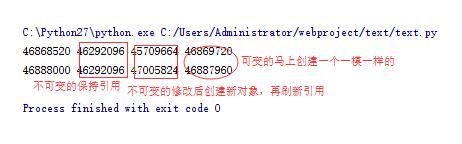
验证正确。
深拷贝的创建:
1.正如代码示例用一样,只能通过内置的copy模块的deepcopy()方法创建。
好了,关于深浅拷贝的问题就先说到这里,有什么错误或需要补充的以后会继续。
以上这篇深入理解python中的浅拷贝和深拷贝就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。