Python 制作糗事百科爬虫实例
早上起来闲来无事做,莫名其妙的就弹出了糗事百科的段子,转念一想既然你送上门来,那我就写个爬虫到你网站上爬一爬吧,一来当做练练手,二来也算找点乐子。
其实这两天也正在接触数据库的内容,可以将爬取下来的数据保存在数据库中,以待以后的利用。好了,废话不多说了,先来看看程序爬取的数据结果
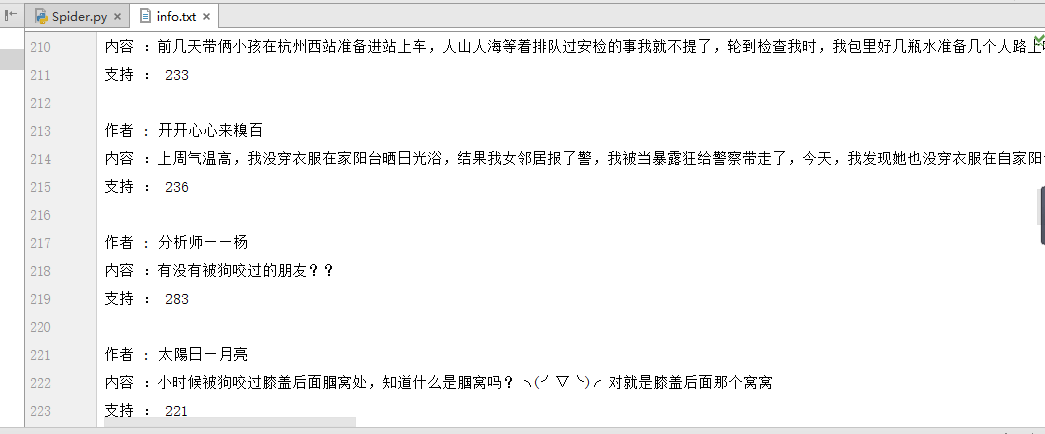
值得一提的是,我在程序中想一下子爬取糗事百科 30 页的内容,但是出现了连接错误,当我把页数降到 20 页的时候,程序就可以正常的跑起来了,不知道是什么原因,渴望知道的大神可以告诉我一声,感激不尽。
程序非常简单,直接上源代码咯
# coding=utf8

import re
import requests
from lxml import etree
from multiprocessing.dummy import Pool as ThreadPool
import sys

reload(sys)
sys.setdefaultencoding('utf-8')


def getnewpage(url, total):
 nowpage = int(re.search('(\d+)', url, re.S).group(1))
 urls = []

 for i in range(nowpage, total + 1):
  link = re.sub('(\d+)', '%s' % i, url, re.S)
  urls.append(link)

 return urls


def spider(url):
 html = requests.get(url)
 selector = etree.HTML(html.text)

 author = selector.xpath('//*[@id="content-left"]/div/div[1]/a[2]/@title')
 content = selector.xpath('//*[@id="content-left"]/div/div[2]/text()')
 vote = selector.xpath('//*[@id="content-left"]/div/div[3]/span/i/text()')

 length = len(author)
 for i in range(0, length):
  f.writelines('作者 : ' + author[i] + '\n')
  f.writelines('内容 :' + str(content[i]).replace('\n','') + '\n')
  f.writelines('支持 : ' + vote[i] + '\n\n')


if __name__ == '__main__':

 f = open('info.txt', 'a')
 url = 'http://www.qiushibaike.com/text/page/1/'
 urls = getnewpage(url, 20)

 pool = ThreadPool(4)
 pool.map(spider,urls)
 f.close()
如果其中有不懂得部分,可以依次参考我的前三篇文章。