python爬虫之百度API调用方法

yipeiwu_com7年前Python爬虫

调用百度API获取经纬度信息。

import requests
import json
address = input('请输入地点:')
par = {'address': address, 'key': 'cb649a25c1f81c1451adbeca73623251'}
url = 'http://restapi.amap.com/v3/geocode/geo'
res = requests.get(url, par)
json_data = json.loads(res.text)
geo = json_data['geocodes'][0]['location']
longitude = geo.split(',')[0]
latitude = geo.split(',')[1]
print(longitude,latitude)

其实调用API不难,这里是get方法,参数是地址和key,这个key是我在网上找的,应该是可以用的。

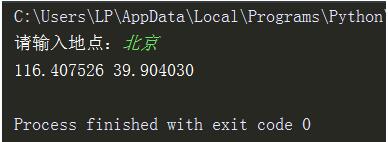
运行下代码。
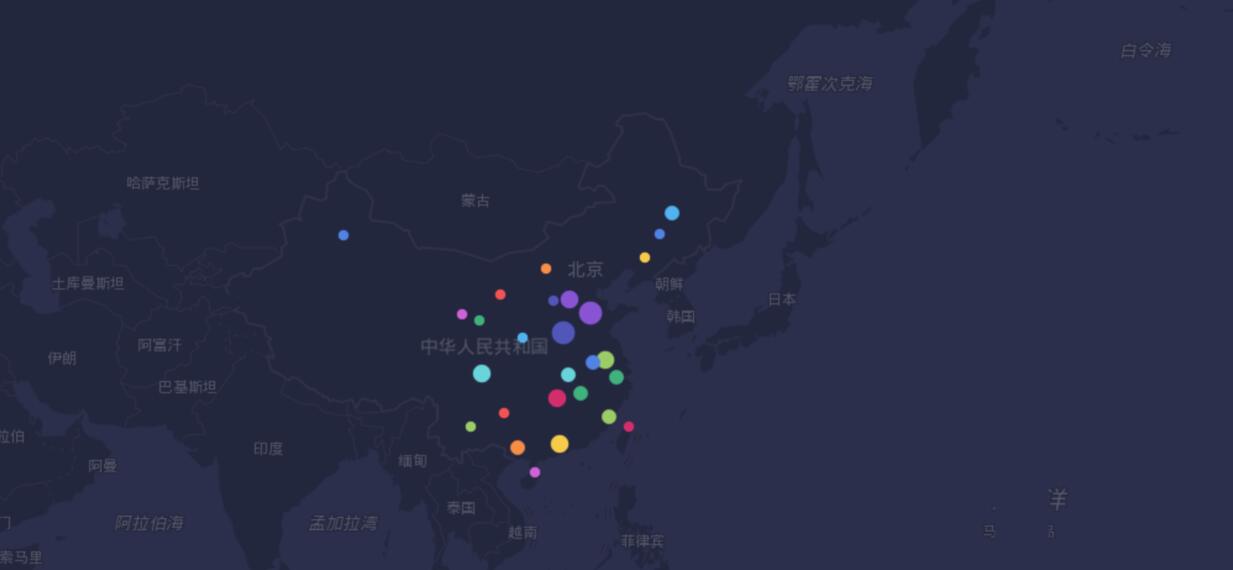
然后糗事百科的地址处理后,调用API即可获得经纬度,然后利用个人BDP即可完成该图。
以上这篇python爬虫之百度API调用方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。
相关文章

python爬虫爬取笔趣网小说网站过程图解

python爬虫爬取笔趣网小说网站过程图解

首先:文章用到的解析库介绍 BeautifulSoup: Beautiful Soup提供一些简单的、python式的函数用来处理导航、搜索、修改分析树等功能。 它是一个工具箱,通过解析...

python爬虫正则表达式之处理换行符

刚开始学python,记录下问题。 代码如下: #coding:utf-8 import re,urllib2 def getHTML(url): html=urllib2.ur...

python爬虫(入门教程、视频教程) 原创

python的版本经过了python2.x和python3.x等版本,无论哪种版本,关于python爬虫相关的知识是融会贯通的,【听图阁-专注于Python设计】关于爬虫这个方便整理过很...

python3抓取中文网页的方法

本文实例讲述了python3抓取中文网页的方法。分享给大家供大家参考。具体如下: #! /usr/bin/python3.2 import sys import urllib.req...

玩转python爬虫之cookie使用方法

玩转python爬虫之cookie使用方法

之前一篇文章我们学习了爬虫的异常处理问题,那么接下来我们一起来看一下Cookie的使用。 为什么要使用Cookie呢? Cookie,指某些网站为了辨别用户身份、进行session跟踪而...