pandas数据预处理之dataframe的groupby操作方法
在数据预处理过程中可能会遇到这样的问题,如下图:数据中某一个key有多组数据,如何分别对每个key进行相同的运算?
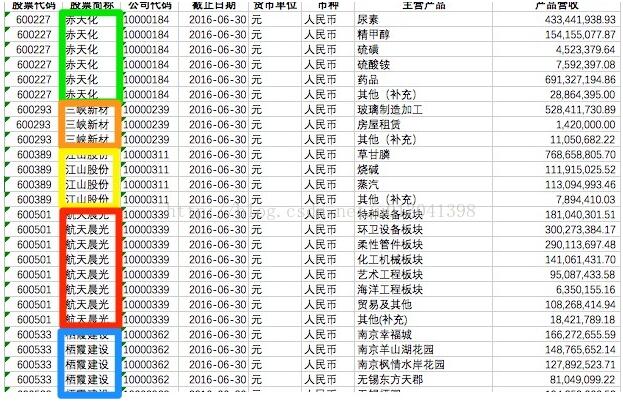
dataframe里面给出了一个group by的一个操作,对于”group by”操作,我们通常是指以下一个或多个操作步骤:
l (Splitting)按照一些规则将数据分为不同的组;
l (Applying)对于每组数据分别执行一个函数;
l (Combining)将结果组合到一个数据结构中;
使用dataframe实现groupby的用法:
# -*- coding: UTF-8 -*-
import pandas as pd
df = pd.DataFrame([{'col1':'a', 'col2':1, 'col3':'aa'}, {'col1':'b', 'col2':2, 'col3':'bb'}, {'col1':'c', 'col2':3, 'col3':'cc'}, {'col1':'a', 'col2':44, 'col3':'aa'}])
print df
# 按col1分组并按col2求和
print df.groupby(by='col1').agg({'col2':sum}).reset_index()
# 按col1分组并按col2求最值
print df.groupby(by='col1').agg({'col2':['max', 'min']}).reset_index()
# 按col1 ,col3分组并按col2求和
print df.groupby(by=['col1', 'col3']).agg({'col2':sum}).reset_index()
输出结果为:
 col1 col2 col3
0  a   1  aa
1  b   2  bb
2  c   3  cc
3  a  44  aa
 col1 col2
0  a  45
1  b   2
2  c   3
 col1 col2
    max min
0  a  44  1
1  b  2  2
2  c  3  3
 col1 col3 col2
0  a  aa  45
1  b  bb   2
2  c  cc   3
注意点:
代码中调用了reset_index() 函数, 如果不使用这个函数输出的结果将是:
   col2
col1
a    45
b    2
c    3
   col2
   max min
col1
a   44  1
b    2  2
c    3  3
      col2
col1 col3
a  aa   45
b  bb    2
c  cc    3
上下两个结果还是有区别的,但是具体区别暂时不太清楚,不过下面的一种输出结果是不能跟使用df['col1']来提取第一列的。至于是什么原因暂时还不清楚,如果您对pandas比较理解或者知道原因,欢迎在评论中留言。
以上这篇pandas数据预处理之dataframe的groupby操作方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。