python获取酷狗音乐top500的下载地址 MP3格式
下面先给大家介绍下python获取酷狗音乐top500的下载地址 MP3格式,具体代码如下所示:
# -*- coding: utf-8 -*-
# @Time : 2018/4/16
# @File : kugou_top500.py
# @Software: PyCharm
# @pyVer : python 2.7
import requests,json
headers={
 'UserAgent' : 'Mozilla/5.0 (iPhone; CPU iPhone OS 5_0 like Mac OS X) AppleWebKit/534.46 (KHTML, like Gecko) Version/5.1 Mobile/9A334 Safari/7534.48.3',
 'Referer' : 'http://m.kugou.com/rank/info/8888',
 'Cookie' : 'UM_distinctid=161d629254c6fd-0b48b34076df63-6b1b1279-1fa400-161d629255b64c; kg_mid=cb9402e79b3c2b7d4fc13cbc85423190; Hm_lvt_aedee6983d4cfc62f509129360d6bb3d=1523818922; Hm_lpvt_aedee6983d4cfc62f509129360d6bb3d=1523819865; Hm_lvt_c0eb0e71efad9184bda4158ff5385e91=1523819798; Hm_lpvt_c0eb0e71efad9184bda4158ff5385e91=1523820047; musicwo17=kugou'
 }
def get_songs(url):
 res=requests.get(url,headers=headers)
 return res.text
def get_song_download_url(url):
 res=requests.get(url,headers=headers)
 res_tmp_list = json.loads(res.text)
 return res_tmp_list['data']['play_url']
def get_song_page_data(url):
 Song_Json = json.loads(get_songs(URL))
 Song_List_Json = Song_Json['data']['info']
 total = []
 for i in range(len(Song_List_Json)):
 song_download_url = "http://www.kugou.com/yy/index.php?r=play/getdata&hash=%s&album_id=%s&_=1523819864065" % (Song_List_Json[i]['hash'], Song_List_Json[i]['album_id'])
 song_data_dict = {'downloadUrl':get_song_download_url(song_download_url),'fileName':Song_List_Json[i]['filename']}
 total.append(song_data_dict)
 return total
for i in range(1,18):
 URL='http://mobilecdngz.kugou.com/api/v3/rank/song?rankid=8888&ranktype=2&page=%s&pagesize=30&volid=&plat=2&version=8955&area_code=1' % i
 page_list_data = get_song_page_data(URL)
 for j in range(len(page_list_data)):
 print "%s %s" % (page_list_data[j]['fileName'],page_list_data[j]['downloadUrl'])
效果
下面看下python--爬取酷狗TOP500的数据
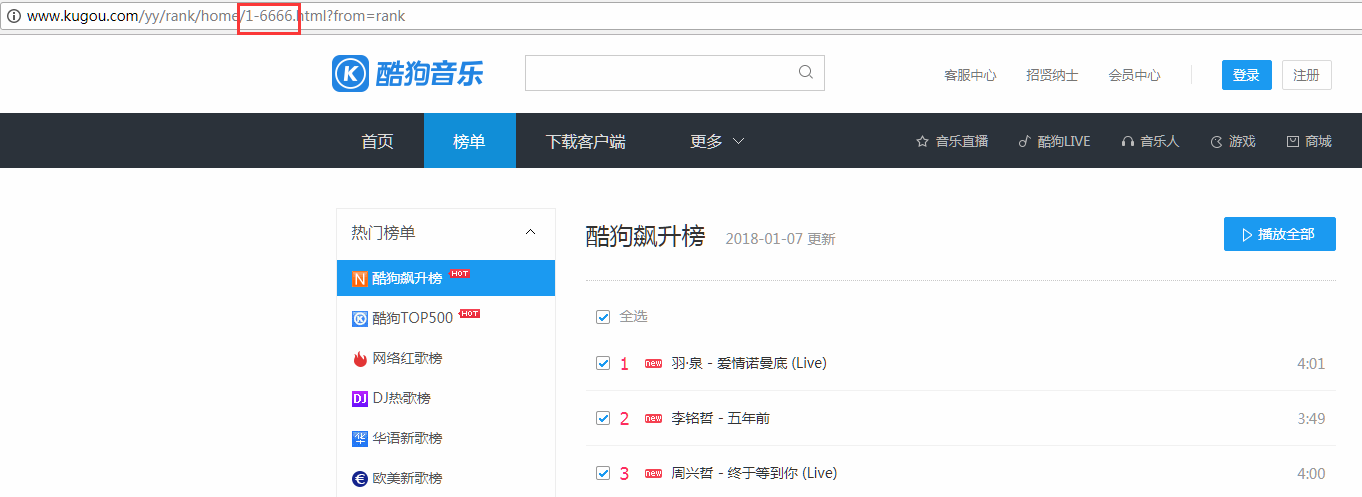
你是不是也遇到不能完整爬取TOP500的数据,因为规律只在前几页有用,后面有小改动,所以中间跳转了,不是完整的TOP500。我换了个方向,爬取飙升榜100首(上面代码)。
希望酷狗给大家个机会哈,毕竟才100首影响不了多大。
from bs4 import BeautifulSoup
import requests
import time
headers={
 'User-Agent':'Mozilla/5.0 (Windows NT 6.1;WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/65.0.3298.4 Safari/537.36'
}
def get_info(url):
 wb_data = requests.get(url,headers=headers)
 soup = BeautifulSoup(wb_data.text,'lxml')
 ranks = soup.select('span.pc_temp_num')
 titles = soup.select('div.pc_temp_songlist > ul > li > a')
 times = soup.select('span.pc_temp_tips_r > span')
 for rank,title,time in zip(ranks,titles,times):
 data= {
  'rank':rank.get_text().strip(),
  'siger':title.get_text().split('-')[0],
  'song':title.get_text().split('-')[1],
  'time':time.get_text().strip()
 }
 print(data)
#酷狗飙升榜100首
if __name__ == '__main__':
 urls = ['http://www.kugou.com/yy/rank/home/{}-6666.html?from=rank/'.format(str(i)) for i in
range(1,6)]
 for url in urls:
 get_info(url)
 time.sleep(2)
总结
以上所述是小编给大家介绍的python获取酷狗音乐top500的下载地址 MP3格,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!