Pandas之drop_duplicates:去除重复项方法

yipeiwu_com7年前Python基础

方法

DataFrame.drop_duplicates(subset=None, keep='first', inplace=False)

参数

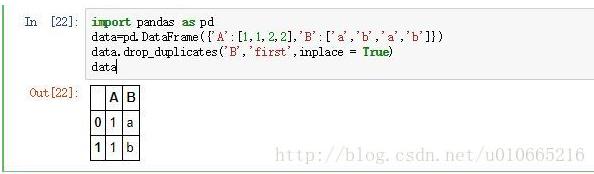
这个drop_duplicate方法是对DataFrame格式的数据,去除特定列下面的重复行。返回DataFrame格式的数据。

subset : column label or sequence of labels, optional 

用来指定特定的列,默认所有列

keep : {‘first', ‘last', False}, default ‘first' 

删除重复项并保留第一次出现的项

inplace : boolean, default False 

是直接在原来数据上修改还是保留一个副本

实验
以上这篇Pandas之drop_duplicates:去除重复项方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。

相关文章

python pickle 和 shelve模块的用法

1.pickle    写: 以写方式打开一个文件描述符,调用pickle.dump把对象写进去复制代码 代码如下:    dn = {...

进一步探究Python中的正则表达式

字符串是编程时涉及到的最多的一种数据结构,对字符串进行操作的需求几乎无处不在。比如判断一个字符串是否是合法的Email地址,虽然可以编程提取@前后的子串,再分别判断是否是单词和域名,但这...

pygame库实现俄罗斯方块小游戏

pygame库实现俄罗斯方块小游戏

本文实例为大家分享了pygame库实现俄罗斯方块小游戏的具体代码,供大家参考,具体内容如下 import random,time,pygame,sys from pygame.loc...

Python基础之函数原理与应用实例详解

本文实例讲述了Python基础之函数原理与应用。分享给大家供大家参考,具体如下: 目标 函数的快速体验 函数的基本使用 函数的参数 函数的返回值 函数的嵌套调用...

Python聚类算法之DBSACN实例分析

Python聚类算法之DBSACN实例分析

本文实例讲述了Python聚类算法之DBSACN。分享给大家供大家参考,具体如下: DBSCAN:是一种简单的,基于密度的聚类算法。本次实现中,DBSCAN使用了基于中心的方法。在基于中...