python通过伪装头部数据抵抗反爬虫的实例
0x00 环境
系统环境:win10
编写工具:JetBrains PyCharm Community Edition 2017.1.2 x64
python 版本:python-3.6.2
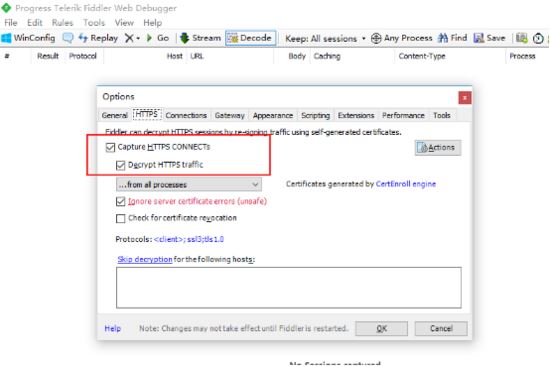
抓包工具:Fiddler 4
0x01 头部数据伪装思路
通过http向服务器提交数据,以下是通过Fiddler 抓取python没有伪装的报文头信息
GET /u012870721 HTTP/1.1
Accept-Encoding: identity
Host: blog.csdn.net
User-Agent: <span style="color:#ff0000;">Python-urllib/3.6</span>
Connection: close
Python-urllib/3.6
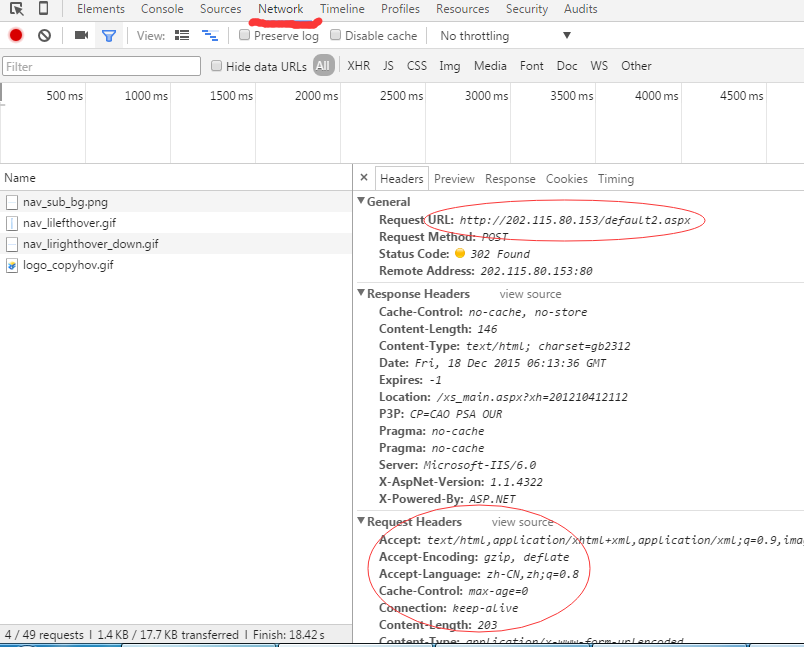
很明显啊,我们暴露了。现在要问了,该怎么!模拟浏览器,让自己伪装成浏览器,一下是浏览器访问发送的头部数据
Connection: keep-alive
Upgrade-Insecure-Requests: 1
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.113 Safari/537.36
Referer: http://write.blog.csdn.net/postlist
Accept-Encoding: gzip, deflate
Accept-Language: zh-CN,zh;q=0.8
0x02代码实现
from urllib import request
html_url = "http://blog.csdn.net/u012870721";
#伪装构造头
header ={
 "Connection": "keep-alive",
 "Upgrade-Insecure-Requests": "1",
 "User-Agent": "Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.113 Safari/537.36",
 "Accept":" text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8",
 "Accept-Encoding": "gzip,deflate",
 "Accept-Language": "zh-CN,zh;q=0.8"
};

#int main()
#{
req = request.Request(url=html_url, headers=header);

resp = request.urlopen(req);
# return 0;
# }
伪装后进行发送的信息头
GET /u012870721 HTTP/1.1
Host: blog.csdn.net
Connection: close
Upgrade-Insecure-Requests: 1
User-Agent: Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/60.0.3112.113 Safari/537.36
Accept: text/html,application/xhtml+xml,application/xml;q=0.9,image/webp,image/apng,*/*;q=0.8
Accept-Encoding: gzip,deflate
Accept-Language: zh-CN,zh;q=0.8
以上这篇python通过伪装头部数据抵抗反爬虫的实例就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。