相关文章
解决Python print 输出文本显示 gbk 编码错误问题
前阵子想爬点东西,结果一直提示错误UnicodeEncodeError: ‘gbk' codec can't encode character ‘\xa0' in position,在网...
基于DATAFRAME中元素的读取与修改方法
DATAFRAME中使用iat[1,0]和iloc[0,1]对元素进行修改。 a = [("hahaha",1),("lalala",2),("cacaca",6)] b = pad...
python 正则式 概述及常用字符
1.元字符: . 它匹配除了换行字符外的任何字符,在 alternate 模式(re.DOTALL)下它甚至可以匹配换行 ^ 匹配行首。除非设置 MULTILINE 标志,它只是匹配字符...
Python高级编程之消息队列(Queue)与进程池(Pool)实例详解
本文实例讲述了Python高级编程之消息队列(Queue)与进程池(Pool)。分享给大家供大家参考,具体如下: Queue消息队列 1.创建 import multiprocess...
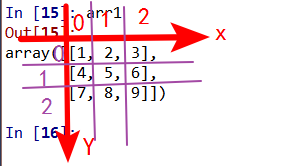
numpy中索引和切片详解
索引和切片 一维数组 一维数组很简单,基本和列表一致。 它们的区别在于数组切片是原始数组视图(这就意味着,如果做任何修改,原始都会跟着更改)。 这也意味着,如果不想更改原始数组,我们需要...