用Python下载一个网页保存为本地的HTML文件实例

yipeiwu_com7年前Python基础

我们可以用Python来将一个网页保存为本地的HTML文件,这需要用到urllib库。

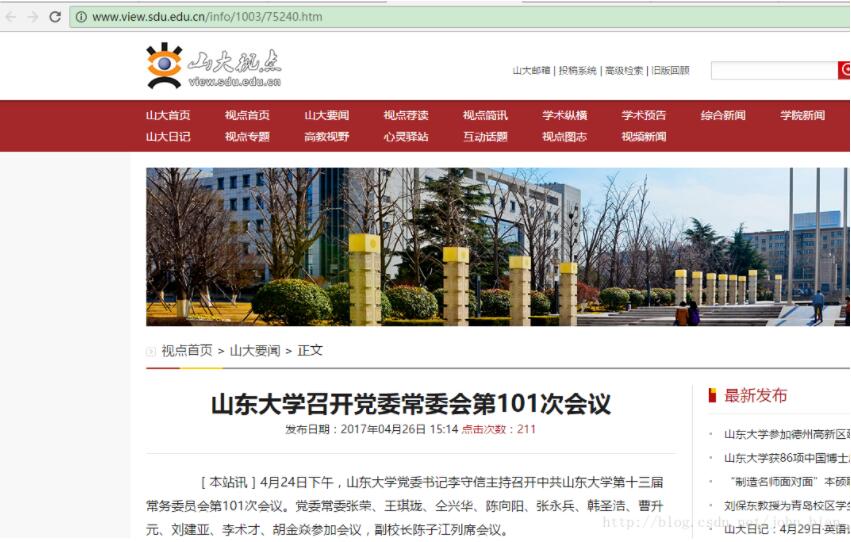
比如我们要下载山东大学新闻网的一个页面,该网页如下:
实现代码如下:

import urllib.request

def getHtml(url):
 html = urllib.request.urlopen(url).read()
 return html

def saveHtml(file_name, file_content):
 # 注意windows文件命名的禁用符,比如 /
 with open(file_name.replace('/', '_') + ".html", "wb") as f:
  # 写文件用bytes而不是str,所以要转码
  f.write(file_content)

aurl = "http://www.view.sdu.edu.cn/info/1003/75240.htm"
html = getHtml(aurl)
saveHtml("sduview", html)

print("下载成功")

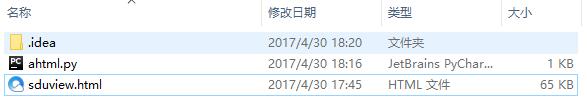
打开相应的目录可以看到这个网页已经被下载保存成功了
我们用浏览器打开这个网页文件如下
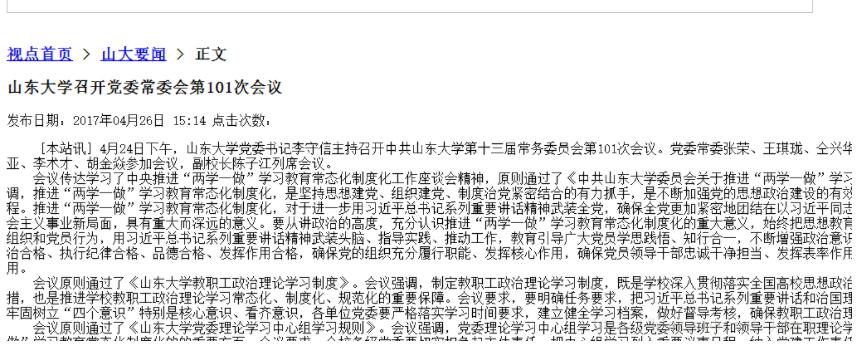
由于我们只是下载了网页的主要源码,其中的很多图片之类的文件都不在这里。因此这种方法只适用于提取文字内容。

以上这篇用Python下载一个网页保存为本地的HTML文件实例就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。
相关文章

Python数据结构与算法之图结构(Graph)实例分析

Python数据结构与算法之图结构(Graph)实例分析

本文实例讲述了Python数据结构与算法之图结构(Graph)。分享给大家供大家参考,具体如下: 图结构(Graph)——算法学中最强大的框架之一。树结构只是图的一种特殊情况。 如果我们...

Python使用asyncio包处理并发详解

阻塞型I/O和GIL CPython 解释器本身就不是线程安全的,因此有全局解释器锁(GIL),一次只允许使用一个线程执行 Python 字节码。因此,一个 Python 进程通常不能同...

django-allauth入门学习和使用详解

django-allauth是集成的Django应用程序,用于解决网站身份验证,用户的注册登录及账户管理,以及第三方(社交)账户的身份验证。 既然你知道并准备使用django-allau...

apache部署python程序出现503错误的解决方法

前言 本文主要给大家介绍了解决apahce部署python程序出现503错误的相关内容,下面话不多说了,下一起看看详细的介绍吧。 发现问题 今天更新服务器后,发现使用apache部署的某...

Python Django框架实现应用添加logging日志操作示例

本文实例讲述了Python Django框架实现应用添加logging日志。分享给大家供大家参考,具体如下: Django uses Python's builtin logging m...