python自动化报告的输出用例详解
1、设计简单的用例
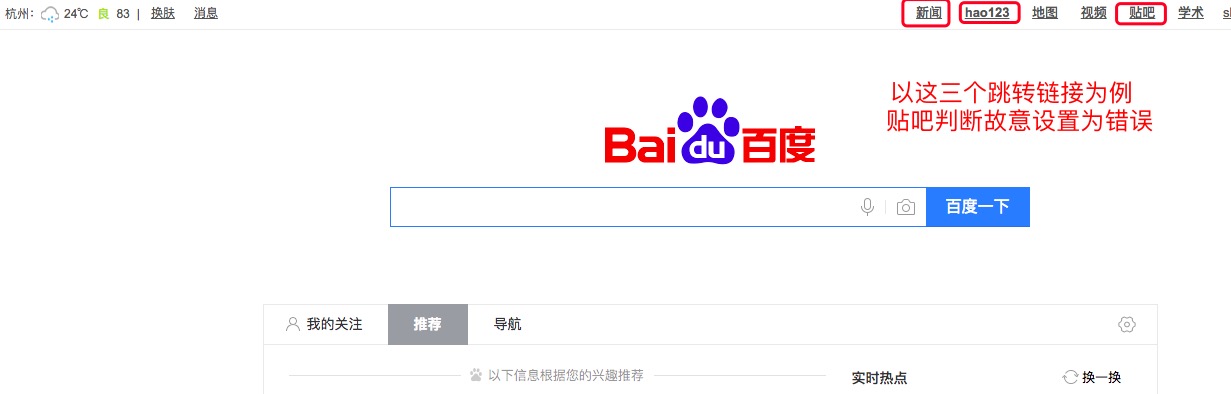
2、设计用例
以TestBaiduLinks.py命名
# coding:utf-8
from selenium import webdriver
import unittest
class BaiduLinks(unittest.TestCase):
 def setUp(self):
  base_url = 'https://www.baidu.com'
  self.driver = webdriver.Chrome()
  self.driver.implicitly_wait(10)
  self.driver.get(base_url)
 def tearDown(self):
  self.driver.close()
  self.driver.quit()
 def test_baidu_news(self):
  u"""百度新闻"""
  driver = self.driver
  driver.find_element_by_link_text('新闻').click()
  self.assertIn(driver.title, u'v百度新闻——全球最大的中文新闻平台')
 def test_baidu_hao123(self):
  u"""hao123"""
  driver = self.driver
  driver.find_element_by_link_text('hao123').click()
  self.assertEqual(driver.title, u'hao123_上网从这里开始')
 def test_baidu_tieba(self):
  u"""百度贴吧"""
  driver = self.driver
  driver.find_element_by_link_text('贴吧').click()
  # 错误的断言
  self.assertTrue(driver.find_element_by_link_text('全吧搜索+1'))
if __name__ == '__main__':
 unittest.main()
 print('百度链接跳转成功')
3、写执行用例脚本
# /usr/bin/env python3
# coding:utf-8
"""
Created on 2018-05-30
Project: learning
@Author:wuya
"""
import os, time, unittest
import HTMLTestRunner
report_path = os.getcwd() # 设置保存报告的路径,这儿设置的是与执行文件在同一个目录下
now = time.strftime("%Y-%m-%d %H:%M", time.localtime(time.time())) # 获取当前时间
title = u"百度头链接测试" # 标题
report_abspath = os.path.join(report_path, title + now + ".html") # 设置报告存放和命名
# 导入用例
def all_case():
 case_path = os.getcwd() # 用例路径,这儿的用例和执行文件在同一目录下
 discover = unittest.defaultTestLoader.discover(case_path,             pattern="Test*.py") # 添加用例,在case_path的路径下,所有以Test开头的文件都当做用例文件执行
 print(discover)
 return discover
if __name__ == "__main__":
 fp = open(report_abspath, "wb") # 保存报告文件
 runner = HTMLTestRunner.HTMLTestRunner(stream=fp,           title=title + ':',)
 runner.run(all_case()) # 执行用例
 fp.close()
4、执行结果
结果文档下载

对于执行不通过的用例可以点击错误二字查看详情

总结
以上所述是小编给大家介绍的python自动化报告的输出用例详解,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!