python面向对象多线程爬虫爬取搜狐页面的实例代码
首先我们需要几个包:requests, lxml, bs4, pymongo, redis
1. 创建爬虫对象,具有的几个行为:抓取页面,解析页面,抽取页面,储存页面
class Spider(object):
 def __init__(self):
  # 状态(是否工作)
  self.status = SpiderStatus.IDLE
 # 抓取页面
 def fetch(self, current_url):
  pass
 # 解析页面
 def parse(self, html_page):
  pass
 # 抽取页面
 def extract(self, html_page):
  pass
 # 储存页面
 def store(self, data_dict):
  pass
2. 设置爬虫属性,没有在爬取和在爬取中,我们用一个类封装, @unique使里面元素独一无二,Enum和unique需要从 enum里面导入:
@unique
class SpiderStatus(Enum):
 IDLE = 0
 WORKING = 1
3. 重写多线程的类:
class SpiderThread(Thread):
 def __init__(self, spider, tasks):
  super().__init__(daemon=True)
  self.spider = spider
  self.tasks = tasks
 def run(self):
  while True:
   pass
4. 现在爬虫的基本结构已经做完了,在main函数创建tasks, Queue需要从queue里面导入:
def main():
 # list没有锁,所以使用Queue比较安全, task_queue=[]也可以使用,Queue 是先进先出结构, 即 FIFO
 task_queue = Queue()
 # 往队列放种子url, 即搜狐手机端的url
 task_queue.put('http://m.sohu,com/')
 # 指定起多少个线程
 spider_threads = [SpiderThread(Spider(), task_queue) for _ in range(10)]
 for spider_thread in spider_threads:
  spider_thread.start()
 # 控制主线程不能停下,如果队列里有东西,任务不能停, 或者spider处于工作状态,也不能停
 while task_queue.empty() or is_any_alive(spider_threads):
  pass
 print('Over')
4-1. 而 is_any_threads则是判断线程里是否有spider还活着,所以我们再写一个函数来封装一下:
def is_any_alive(spider_threads):
 return any([spider_thread.spider.status == SpiderStatus.WORKING
    for spider_thread in spider_threads])
5. 所有的结构已经全部写完,接下来就是可以填补爬虫部分的代码,在SpiderThread(Thread)里面,开始写爬虫运行 run 的方法,即线程起来后,要做的事情:
 def run(self):
  while True:
   # 获取url
   current_url = self.tasks_queue.get()
   visited_urls.add(current_url)
   # 把爬虫的status改成working
   self.spider.status = SpiderStatus.WORKING
   # 获取页面
   html_page = self.spider.fetch(current_url)
   # 判断页面是否为空
   if html_page not in [None, '']:
    # 去解析这个页面, 拿到列表
    url_links = self.spider.parse(html_page)
    # 把解析完的结构加到 self.tasks_queue里面来
    # 没有一次性添加到队列的方法 用循环添加算求了
    for url_link in url_links:
     self.tasks_queue.put(url_link)
   # 完成任务,状态变回IDLE
   self.spider.status = SpiderStatus.IDLE
6. 现在可以开始写 Spider()这个类里面的四个方法,首先写fetch()抓取页面里面的:
@Retry()
 def fetch(self, current_url, *, charsets=('utf-8', ), user_agent=None, proxies=None):
  thread_name = current_thread().name
  print(f'[{thread_name}]: {current_url}')
  headers = {'user-agent': user_agent} if user_agent else {}
  resp = requests.get(current_url,
       headers=headers, proxies=proxies)
  # 判断状态码,只要200的页面
  return decode_page(resp.content, charsets) \
   if resp.status_code == 200 else None
6-1. decode_page是我们在类的外面封装一个解码的函数:
def decode_page(page_bytes, charsets=('utf-8',)):
 page_html = None
 for charset in charsets:
  try:
   page_html = page_bytes.decode(charset)
   break
  except UnicodeDecodeError:
   pass
   # logging.error('Decode:', error)
 return page_html
6-2. @retry是装饰器,用于重试, 因为需要传参,在这里我们用一个类来包装, 所以最后改成@Retry():
# retry的类,重试次数3次,时间5秒(这样写在装饰器就不用传参数类), 异常
class Retry(object):
 def __init__(self, *, retry_times=3, wait_secs=5, errors=(Exception, )):
  self.retry_times = retry_times
  self.wait_secs = wait_secs
  self.errors = errors
 # call 方法传参
 def __call__(self, fn):
  def wrapper(*args, **kwargs):
   for _ in range(self.retry_times):
    try:
     return fn(*args, **kwargs)
    except self.errors as e:
     # 打日志
     logging.error(e)
     # 最小避让 self.wait_secs 再发起请求(最小避让时间)
     sleep((random() + 1) * self.wait_secs)
   return None
  return wrapper()
7. 接下来写解析页面的方法,即 parse():
# 解析页面
 def parse(self, html_page, *, domain='m.sohu.com'):
  soup = BeautifulSoup(html_page, 'lxml')
  url_links = []
  # 找body的有 href 属性的 a 标签
  for a_tag in soup.body.select('a[href]'):
   # 拿到这个属性
   parser = urlparse(a_tag.attrs['href'])
   netloc = parser.netloc or domain
   scheme = parser.scheme or 'http'
   netloc = parser.netloc or 'm.sohu.com'
   # 只爬取 domain 底下的
   if scheme != 'javascript' and netloc == domain:
    path = parser.path
    query = '?' + parser.query if parser.query else ''
    full_url = f'{scheme}://{netloc}{path}{query}'
    if full_url not in visited_urls:
     url_links.append(full_url)
  return url_links
7-1. 我们需要在SpiderThread()的 run方法里面,在
current_url = self.tasks_queue.get()
下面添加
visited_urls.add(current_url)
在类外面再添加一个
visited_urls = set()去重
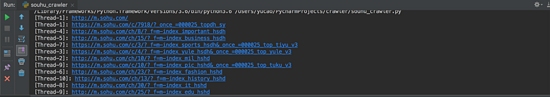
8. 现在已经能开始抓取到相应的网址。
总结
以上所述是小编给大家介绍的python面向对象多线程爬虫爬取搜狐页面的实例代码,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!