浅谈python实现Google翻译PDF,解决换行的问题
我们复制PDF到Google翻译时,总是会出现换行的情况,如果自己手动去除,那就太麻烦了。
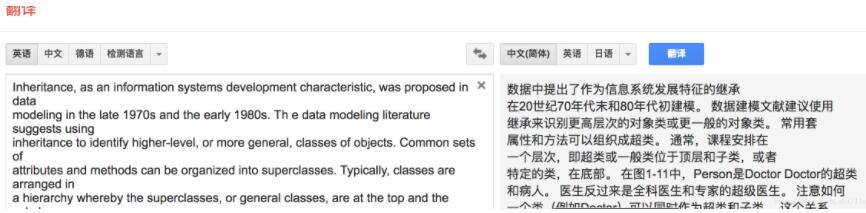
那么用Python就可以解决,复制到粘贴板以后,Python程序自动可以把\n换成空格,然后我们就可以复制到Google翻译中去
代码:
import pyperclip
import time
import webbrowser
copyBuff=' '
while True:
 time.sleep(10)
 copyedText=pyperclip.paste()
 if copyBuff!=copyedText:
  copyBuff=copyedText
  normalizedText = copyBuff.replace('\n', ' ')
  pyperclip.copy(normalizedText)
 else:
  print('no change')
这样一来,其实还是有点麻烦,我们想如果复制完以后,自动把复制内容用谷歌翻译就好了,所以稍微更改一下代码
import pyperclip
import time
import webbrowser
copyBuff=' '
while True:
 time.sleep(10)
 copyedText=pyperclip.paste()
 if copyBuff!=copyedText:
  copyBuff=copyedText

  normalizedText = copyBuff.replace('\n', ' ')

  url='https://translate.google.cn/#en/zh-CN/'+normalizedText

  #webbrowser.open(url)之前这么做的,默认用Safari打开,404 not found
  #所以要用chrome打开就OK啦
  w = webbrowser.get('chrome')
  w.open(url)

 else:
  print('no change')
完美!
以上这篇浅谈python实现Google翻译PDF,解决换行的问题就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。