Python3爬虫学习之将爬取的信息保存到本地的方法详解
本文实例讲述了Python3爬虫学习之将爬取的信息保存到本地的方法。分享给大家供大家参考,具体如下:
将爬取的信息存储到本地
之前我们都是将爬取的数据直接打印到了控制台上,这样显然不利于我们对数据的分析利用,也不利于保存,所以现在就来看一下如何将爬取的数据存储到本地硬盘。
1 对.txt文件的操作
读写文件是最常见的操作之一,python3 内置了读写文件的函数:open
open(file, mode='r', buffering=-1, encoding=None, errors=None, newline=None, closefd=True, opener=None))
Open file and return a corresponding file object. If the file cannot be opened, an OSError
is raised.
其中比较常用的参数为file和mode,参数file为文件的路径,参数mode为操作文件的方式(读/写),函数的返回值为一个file对象,如果文件操作出现异常的话,则会抛出 一个OSError
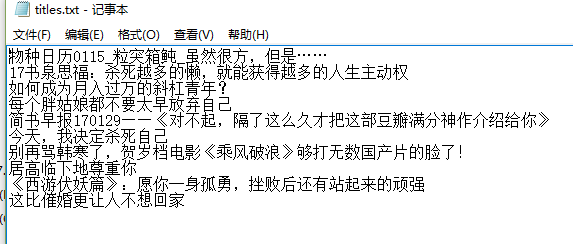
还以简书首页文章题目为例,将爬取到的文章标题存放到一个.txt文件中,具体代码如下:
# -*- coding:utf-8 -*-
from urllib import request
from bs4 import BeautifulSoup
url = r'http://www.jianshu.com'
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}
page = request.Request(url, headers=headers)
page_info = request.urlopen(page).read().decode('utf-8')
soup = BeautifulSoup(page_info, 'html.parser')
titles = soup.find_all('a', 'title')
try:
  # 在E盘以只写的方式打开/创建一个名为 titles 的txt文件
  file = open(r'E:\titles.txt', 'w')
  for title in titles:
  # 将爬去到的文章题目写入txt中
    file.write(title.string + '\n')
finally:
  if file:
    # 关闭文件(很重要)
    file.close()
open中mode参数的含义见下表:
| 符号 | 含义 |
|---|---|
| r' | 以只读模式打开文件(默认模式) |
| w' | 以只写的方式打开文件,如果文件存在的话会先删除再重新创建 |
| x' | 以独占的方式打开文件,如果文件已经存在则错误 |
| a' | 以写的形式打开文件,若文件已存在,则以追加的方式写入 |
| b' | 二进制模式 |
| t' | 文本模式(默认) |
| +' | 更新文件(读/写) |
其中't'为默认模式,'r'相当于'rt',符号可以叠加使用,像'r+b'
另外,对文件操作一定要注意的一点是:打开的文件一定要关闭,否则会占用相当大的系统资源,所以对文件的操作最好使用try:...finally:...的形式。但是try:...finally:...的形式会使代码显得比较杂乱,所幸python中的with语句可以帮我们自动调用close()而不需要我们写出来,所以,上面代码中的try:...finally:...可使用下面的with语句来代替:
with open(r'E:\title.txt', 'w') as file:
  for title in titles:
    file.write(title.string + '\n')
效果是一样的,建议使用with语句
2 图片的储存
有时候我们的爬虫不一定只是爬取文本数据,也会爬取一些图片,下面就来看怎么将爬取的图片存到本地磁盘。
我们先来选好目标,知乎话题:女生怎么健身锻造好身材? (单纯因为图多,不要多想哦 (# _ # ) )
看下页面的源代码,找到话题下图片链接的格式,如图:

可以看到,图片在img标签中,且class=origin_image zh-lightbox-thumb,而且链接是由.jpg结尾,我们便可以用Beautiful Soup结合正则表达式的方式来提取所有链接,如下:
links = soup.find_all('img', "origin_image zh-lightbox-thumb",src=re.compile(r'.jpg$'))
提取出所有链接后,使用request.urlretrieve来将所有链接保存到本地
Copy a network object denoted by a URL to a local file. If the URL points to a local file, the object will not be copied unless filename is supplied. Return a tuple (filename, headers)
where filename is the local file name under which the object can be found, and headers is whatever the info()
method of the object returned by urlopen()
returned (for a remote object). Exceptions are the same as for urlopen()
.
具体实现代码如下:
# -*- coding:utf-8 -*-
import time
from urllib import request
from bs4 import BeautifulSoup
import re
url = r'https://www.zhihu.com/question/22918070'
headers = {'User-Agent':'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/55.0.2883.87 Safari/537.36'}
page = request.Request(url, headers=headers)
page_info = request.urlopen(page).read().decode('utf-8')
soup = BeautifulSoup(page_info, 'html.parser')
# Beautiful Soup和正则表达式结合,提取出所有图片的链接(img标签中,class=**,以.jpg结尾的链接)
links = soup.find_all('img', "origin_image zh-lightbox-thumb",src=re.compile(r'.jpg$'))
# 设置保存的路径,否则会保存到程序当前路径
local_path = r'E:\Pic'
for link in links:
  print(link.attrs['src'])
  # 保存链接并命名,time防止命名冲突
  request.urlretrieve(link.attrs['src'], local_path+r'\%s.jpg' % time.time())
运行结果
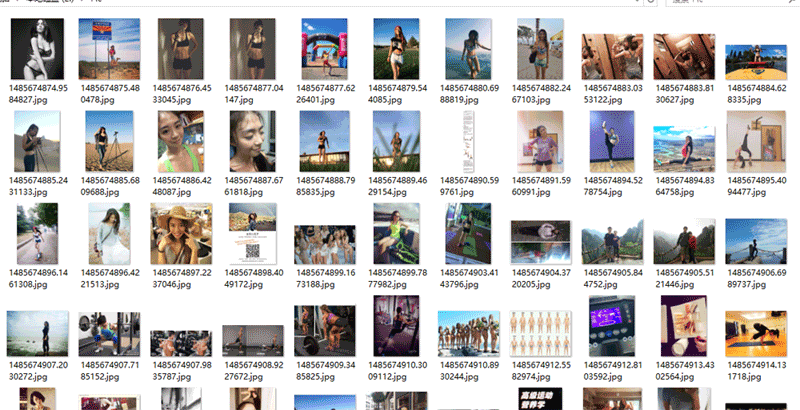
PS:希望大家进行图片爬取的时候,尽量不要将爬下来图片作为商用,特别是摄影作品,都是具有版权的,嗯。。。还有就是注意营养哦~~~
更多关于Python相关内容可查看本站专题:《Python Socket编程技巧总结》、《Python正则表达式用法总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。