使用urllib库的urlretrieve()方法下载网络文件到本地的方法
概述
见源码
源码
# !/usr/bin/env python
# -*- coding:utf-8 -*-


"""
图片(文件)下载,核心方法是 urllib.urlrequest 模块的 urlretrieve()方法
 urlretrieve(url, filename=None, reporthook=None, data=None)
 url: 文件url
 filename: 保存到本地时,使用的文件(路径)名称
 reporthook: 文件传输时的回调函数
 data: post提交到服务器的数据
 该方法返回一个二元元组("本地文件路径",<http.client.HTTPMessage对象>)
"""

import requests
import urllib.request
from lxml import etree


def crawl():
 url='http://www.ivsky.com/tupian/haiyangshijie/'
 headers={
 "User-Agent":"Mozilla/5.0 (X11; Linux x86_64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.108 Safari/537.36",
 }

 resp=requests.get(url,headers=headers)

 if resp.status_code==200:
 resp.encoding='UTF-8'
 html=etree.HTML(resp.text)

 img_titles=html.xpath('//ul[@class="ali"]//a/@title')
 img_urls=html.xpath('//ul[@class="ali"]//a/img/@src')

 data=zip(img_titles,img_urls)
 for img_title,img_url in data:
  print('开始下载{title}.jpg'.format(title=img_title))
  result=urllib.request.urlretrieve(img_url,
     filename='../../data/图片下载爬虫/{title}.jpg'.format(title=img_title),
     reporthook=loading,
     data=None)
  # print(result)

def loading(blocknum,blocksize,totalsize):
 """
 回调函数: 数据传输时自动调用
 blocknum:已经传输的数据块数目
 blocksize:每个数据块字节
 totalsize:总字节
 """
 percent=int(100*blocknum*blocksize/totalsize)
 if percent>100:
 percent=100
 print("正在下载>>>{}%".format(percent))
 import time
 time.sleep(0.5)


if __name__ == '__main__':
 crawl()
运行结果
开始下载海里的海龟图片.jpg
正在下载>>>0%
正在下载>>>100%
开始下载绮丽的海底世界图片.jpg
正在下载>>>0%
正在下载>>>43%
正在下载>>>87%
正在下载>>>100%
开始下载可爱的海豹图片.jpg
正在下载>>>0%
正在下载>>>50%
正在下载>>>100%
开始下载不同的海星图片.jpg
正在下载>>>0%
正在下载>>>63%
正在下载>>>100%
开始下载可爱的水母图片.jpg
正在下载>>>0%
正在下载>>>100%
开始下载活泼可爱的海豚图片.jpg
正在下载>>>0%
正在下载>>>47%
正在下载>>>95%
正在下载>>>100%
开始下载阳光下的海胆壳图片.jpg
正在下载>>>0%
正在下载>>>63%
正在下载>>>100%
开始下载海洋中的水母图片.jpg
正在下载>>>0%
正在下载>>>56%
正在下载>>>100%
开始下载千姿百态的海螺图片.jpg
正在下载>>>0%
正在下载>>>62%
正在下载>>>100%
开始下载水族馆里的水生动植物图片.jpg
正在下载>>>0%
正在下载>>>46%
正在下载>>>93%
正在下载>>>100%
开始下载水母图片.jpg
正在下载>>>0%
正在下载>>>100%
开始下载海星摄影图片.jpg
正在下载>>>0%
正在下载>>>79%
正在下载>>>100%
开始下载五彩斑斓的海洋鱼群图片.jpg
正在下载>>>0%
正在下载>>>29%
正在下载>>>59%
正在下载>>>89%
正在下载>>>100%
开始下载漂亮的贝壳图片.jpg
正在下载>>>0%
正在下载>>>39%
正在下载>>>79%
正在下载>>>100%
开始下载海底水母图片.jpg
正在下载>>>0%
正在下载>>>82%
正在下载>>>100%
开始下载海底的珊瑚图片.jpg
正在下载>>>0%
正在下载>>>48%
正在下载>>>97%
正在下载>>>100%
开始下载海星高清图片.jpg
正在下载>>>0%
正在下载>>>25%
正在下载>>>50%
正在下载>>>75%
正在下载>>>100%
开始下载色彩鲜艳的热带海洋鱼图片.jpg
正在下载>>>0%
正在下载>>>63%
正在下载>>>100%
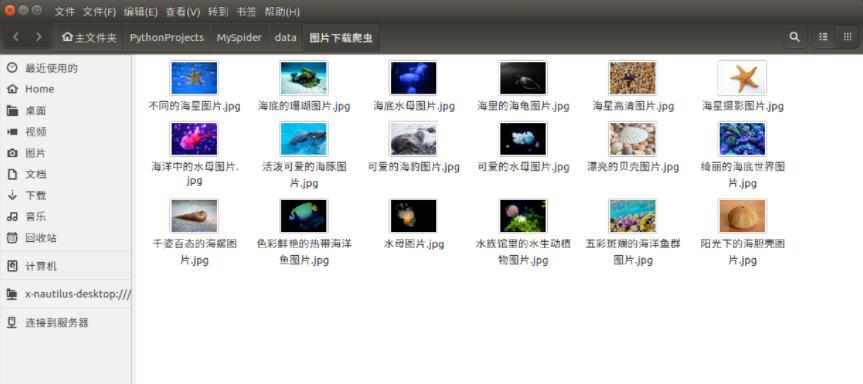
以上这篇使用urllib库的urlretrieve()方法下载网络文件到本地的方法就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。