python3.4爬虫demo
python 3.4 所写爬虫
仅仅是个demo,以百度图片首页图片为例。能跑出图片上的图片;
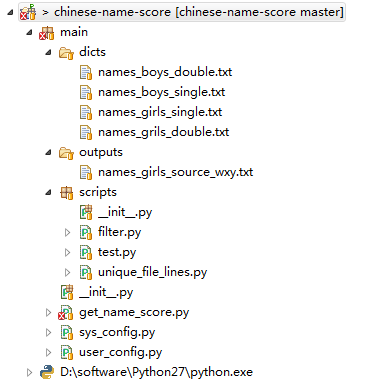
使用 eclipse pydev 编写:
from SpiderSimple.HtmLHelper import *
import imp
import sys
imp.reload(sys)
#sys.setdefaultencoding('utf-8')
html = getHtml('http://image.baidu.com/')
try:
  getImage(html)
  exit()
except Exception as e:
  print(e)
HtmlHelper.py文件
上面的 SpiderSimple是自定义的包名
from urllib.request import urlopen,urlretrieve
#正则库
import re
#打开网页
def getHtml(url):
  page = urlopen(url)
  html = page.read()
  return html
#用正则爬里面的图片地址
def getImage(Html):
  try:
    #reg = r'src="(.+?\.jpg)" class'
    #image = re.compile(reg)
    image = re.compile(r'<img[^>]*src[=\"\']+([^\"\']*)[\"\'][^>]*>', re.I)
    Html = Html.decode('utf-8')
    imaglist = re.findall(image,Html)
    x =0
    for imagurl in imaglist:
      #将图片一个个下载到项目所在文件夹
      urlretrieve(imagurl, '%s.jpg' % x)
      x+=1
  except Exception as e:
    print(e)
要注意个大问题,python 默认编码的问题。
有可能报UnicodeDecodeError: 'ascii' codec can't decode byte 0x?? in position 1: ordinal not in range(128),错误。这个要设置python的默认编码为utf-8.
设置最好的方式是写bat文件,
echo off
set PYTHONIOENCODING=utf8
python -u %1
然后重启电脑。
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,谢谢大家对【听图阁-专注于Python设计】的支持。如果你想了解更多相关内容请查看下面相关链接