解决Python selenium get页面很慢时的问题
driver.get("url")等到页面全部加载渲染完成后才会执行后续的脚本。
在执行脚本时,driver.get("url") ,如果当前的url页面内容较多加载特别慢,很费时间,但是我们需要操作的元素已经加载出来,可以将页面加载停掉,不影响后面的脚本执行,解决办法
设置页面加载timeout,get操作: try get except 脚本window.stop(), 使用GeckoDriver上有效果,
但是在ChromeDriver上还是会有问题,抛出异常timeout后续脚本不会继续执行
GeckoDriver执行具体如下:
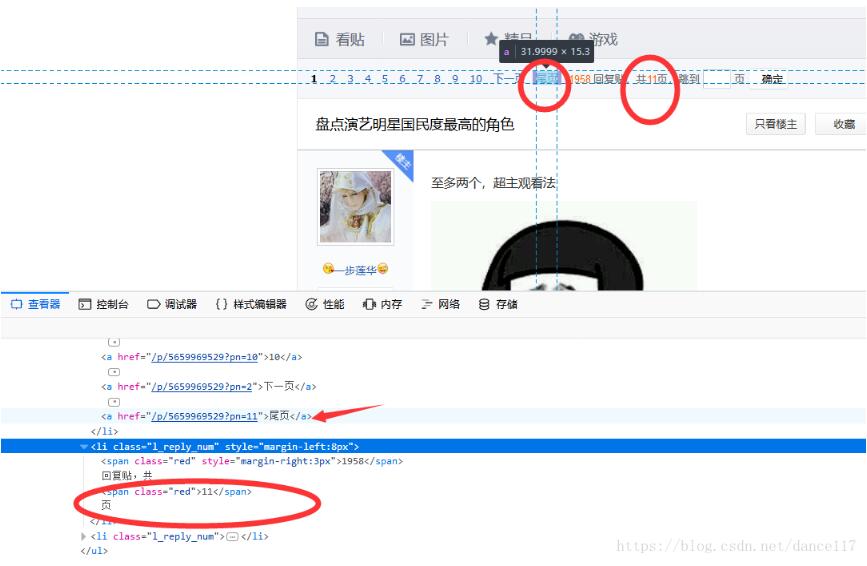
访问百度贴吧某个获取其帖子总页数:
可以通过两种方式获取,简单的就是直接定位元素共11页
代码用定位尾页获取总页数
from selenium import webdriver
import re

driver = webdriver.Firefox()
#设定页面加载timeout时长,需要的元素能加载出来就行
driver.set_page_load_timeout(20)
driver.set_script_timeout(20)
#try去get
try:
  driver.get("http://tieba.baidu.com/p/5659969529?red_tag=w0852861182")
except:
  print("加载页面太慢,停止加载,继续下一步操作")
  driver.execute_script("window.stop()")
last_page_element = driver.find_element_by_css_selector("li.l_pager.pager_theme_4.pb_list_pager >a:nth-child(12)") #定位到元素尾页元素
#获取尾页页码链接文本
text = last_page_element.get_attribute("href")
all_page_num = re.search("\d+$",text).group() # 正则匹配到页码
print("当前贴吧贴子总页数为:%s"%all_page_num)
以上这篇解决Python selenium get页面很慢时的问题就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。