浅谈Python爬虫基本套路
什么是爬虫?
网络爬虫也叫网络蜘蛛,如果把互联网比喻成一个蜘蛛网,那么蜘蛛就是在网上爬来爬去的蜘蛛,爬虫程序通过请求url地址,根据响应的内容进行解析采集数据,
比如:如果响应内容是html,分析dom结构,进行dom解析、或者正则匹配,如果响应内容是xml/json数据,就可以转数据对象,然后对数据进行解析。
有什么作用?
通过有效的爬虫手段批量采集数据,可以降低人工成本,提高有效数据量,给予运营/销售的数据支撑,加快产品发展。
业界的情况
目前互联网产品竞争激烈,业界大部分都会使用爬虫技术对竞品产品的数据进行挖掘、采集、大数据分析,这是必备手段,并且很多公司都设立了爬虫工程师的岗位
合法性
爬虫是利用程序进行批量爬取网页上的公开信息,也就是前端显示的数据信息。因为信息是完全公开的,所以是合法的。其实就像浏览器一样,浏览器解析响应内容并渲染为页面,而爬虫解析响应内容采集想要的数据进行存储。
反爬虫
爬虫很难完全的制止,道高一尺魔高一丈,这是一场没有硝烟的战争,码农VS码农
反爬虫一些手段:
- 合法检测:请求校验(useragent,referer,接口加签名,等)
- 小黑屋:IP/用户限制请求频率,或者直接拦截
- 投毒:反爬虫高境界可以不用拦截,拦截是一时的,投毒返回虚假数据,可以误导竞品决策
- ... ...
爬虫的基本套路
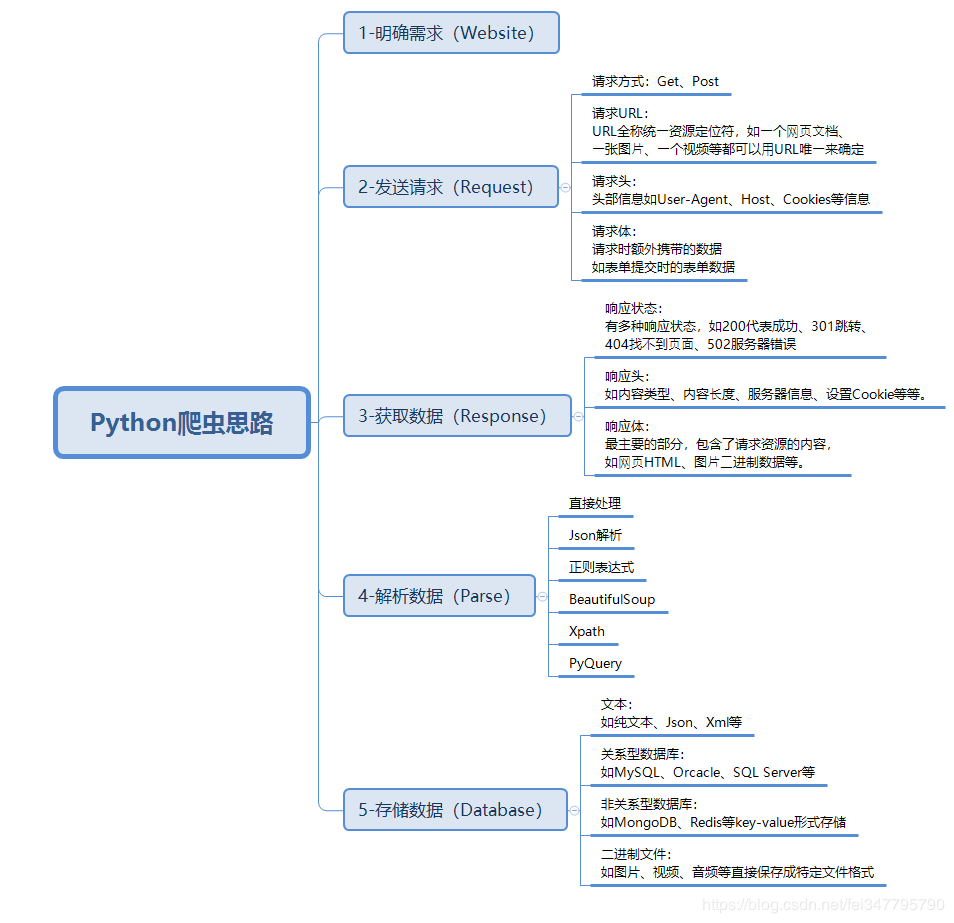
python爬虫
python写爬虫的优势
- python语法易学,容易上手
- 社区活跃,实现方案多可参考
- 各种功能包丰富
- 少量代码即可完成强大功能
涉及模块包
请求
- urllib
- urllib2
- cookielib
多线程
- threading
正则
- re
json解析
- json
html dom解析
- pyquery
- beautiful soup
操作浏览器
- selenium
以上所述是小编给大家介绍的Python爬虫基本套路详解整合,希望对大家有所帮助,如果大家有任何疑问请给我留言,小编会及时回复大家的。在此也非常感谢大家对【听图阁-专注于Python设计】网站的支持!