Python搭建Spark分布式集群环境
前言
Apache Spark 是一个新兴的大数据处理通用引擎,提供了分布式的内存抽象。Spark 最大的特点就是快,可比 Hadoop MapReduce 的处理速度快 100 倍。本文没有使用一台电脑上构建多个虚拟机的方法来模拟集群,而是使用三台电脑来搭建一个小型分布式集群环境安装。
本教程采用Spark2.0以上版本(比如Spark2.0.2、Spark2.1.0等)搭建集群,同样适用于搭建Spark1.6.2集群。
安装Hadoop并搭建好Hadoop集群环境
Spark分布式集群的安装环境,需要事先配置好Hadoop的分布式集群环境。
安装Spark
这里采用3台机器(节点)作为实例来演示如何搭建Spark集群,其中1台机器(节点)作为Master节点,另外两台机器(节点)作为Slave节点(即作为Worker节点),主机名分别为Slave01和Slave02。
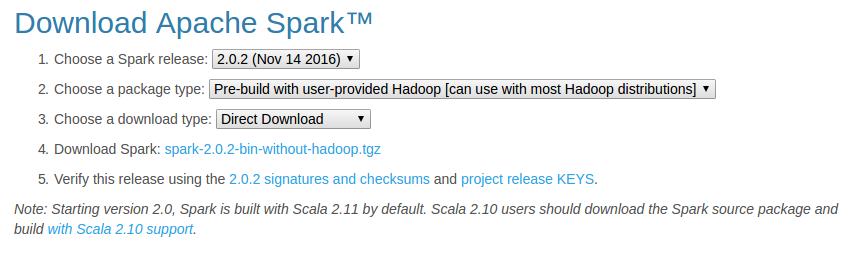
在Master节点机器上,访问Spark官方下载地址,按照如下图下载。
下载完成后,执行如下命令:
sudo tar -zxf ~/下载/spark-2.0.2-bin-without-hadoop.tgz -C /usr/local/
cd /usr/local
sudo mv ./spark-2.0.2-bin-without-hadoop/ ./spark
sudo chown -R hadoop ./spark
配置环境变量
在Mster节点主机的终端中执行如下命令:
vim ~/.bashrc
在.bashrc添加如下配置:
export SPARK_HOME=/usr/local/spark
export PATH=$PATH:$SPARK_HOME/bin:$SPARK_HOME/sbin
执行如下命令使得配置立即生效:
source ~/.bashrc
Spark配置
在Master节点主机上进行如下操作:
配置slaves文件
将 slaves.template 拷贝到 slaves
cd /usr/local/spark/
cp ./conf/slaves.template ./conf/slaves
slaves文件设置Worker节点。编辑slaves内容,把默认内容localhost替换成如下内容:
slave01
slave02
配置spark-env.sh文件
将 spark-env.sh.template 拷贝到 spark-env.sh
cp ./conf/spark-env.sh.template ./conf/spark-env.sh
编辑spark-env.sh,添加如下内容:
export SPARK_DIST_CLASSPATH=$(/usr/local/hadoop/bin/hadoop classpath)
export HADOOP_CONF_DIR=/usr/local/hadoop/etc/hadoop
export SPARK_MASTER_IP=192.168.1.104
SPARK_MASTER_IP 指定 Spark 集群 Master 节点的 IP 地址;
配置好后,将Master主机上的/usr/local/spark文件夹复制到各个节点上。在Master主机上执行如下命令:
cd /usr/local/
tar -zcf ~/spark.master.tar.gz ./spark
cd ~
scp ./spark.master.tar.gz slave01:/home/hadoop
scp ./spark.master.tar.gz slave02:/home/hadoop
在slave01,slave02节点上分别执行下面同样的操作:
sudo rm -rf /usr/local/spark/
sudo tar -zxf ~/spark.master.tar.gz -C /usr/local
sudo chown -R hadoop /usr/local/spark
启动Spark集群
启动Hadoop集群
启动Spark集群前,要先启动Hadoop集群。在Master节点主机上运行如下命令:
cd /usr/local/hadoop/
sbin/start-all.sh
启动Spark集群
1.启动Master节点
在Master节点主机上运行如下命令:
cd /usr/local/spark/
sbin/start-master.sh
在Master节点上运行jps命令,可以看到多了个Master进程:
15093 Jps
14343 SecondaryNameNode
14121 NameNode
14891 Master
14509 ResourceManager
2.启动所有Slave节点
在Master节点主机上运行如下命令:
sbin/start-slaves.sh
分别在slave01、slave02节点上运行jps命令,可以看到多了个Worker进程
37553 DataNode
37684 NodeManager
37876 Worker
37924 Jps
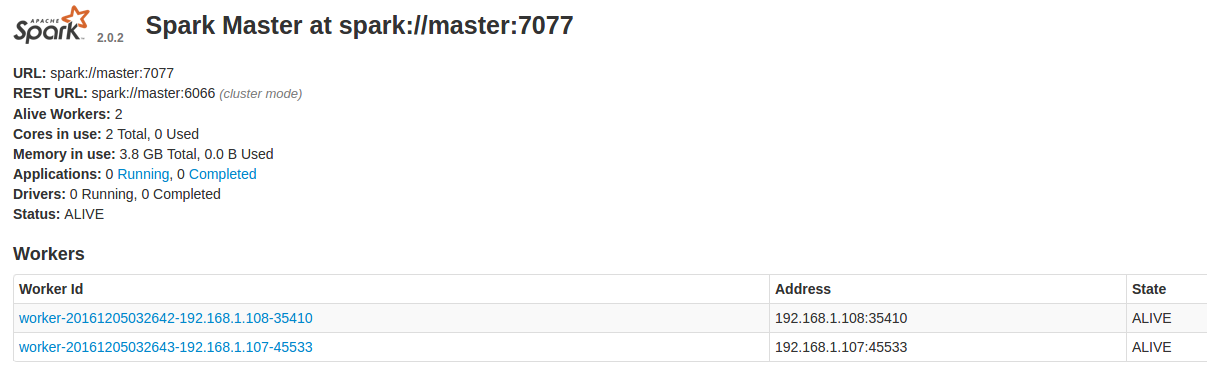
3.在浏览器上查看Spark独立集群管理器的集群信息
在master主机上打开浏览器,访问http://master:8080,如下图:
关闭Spark集群
1.关闭Master节点
sbin/stop-master.sh
2.关闭Worker节点
sbin/stop-slaves.sh
3.关闭Hadoop集群
cd /usr/local/hadoop/
sbin/stop-all.sh
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。