python正则爬取某段子网站前20页段子(request库)过程解析
首先还是谷歌浏览器抓包对该网站数据进行分析,结果如下:
该网站地址:http://www.budejie.com/text
该网站数据都是通过html页面进行展示,网站url默认为第一页,http://www.budejie.com/text/2为第二页,以此类推
对网站的内容段子所处位置进行分析,发现段子内容都是在一个 a 标签中
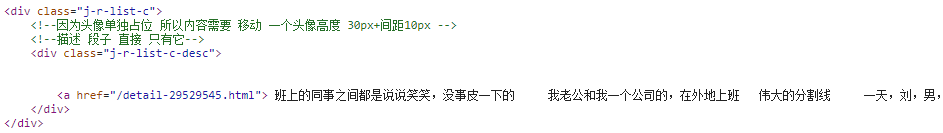
坑还是有的,这是我第一次写的正则:
content_list = re.findall(r'<a href="/detail-.*" rel="external nofollow" rel="external nofollow" rel="external nofollow" >(.+?)</a>', html_str)
之后发现竟然匹配到了一些推荐的内容,最后我把正则改变下面这样,发现没有问题了,关于正则的知识这里就不做过多解释了
content_list = re.findall(r'<div class="j-r-list-c-desc">\s*<a href="/detail-.*" rel="external nofollow" rel="external nofollow" rel="external nofollow" >(.+?)</a>', html_str)
现在要的是爬取前20页的段子并保存到本地,已经知道翻页的规律和匹配内容的正则,就直接可以写代码了
代码如下,整体思路还是和前两排爬虫博客一样,面向对象的写法:
import requests
import re
import json

class NeihanSpider(object):
  """内涵段子,百思不得其姐,正则爬取一页的数据"""
  def __init__(self):
    self.temp_url = 'http://www.budejie.com/text/{}' # 网站地址,给页码留个可替换的{}
    self.headers = {
      'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/75.0.3770.100 Safari/537.36',
    }

  def pass_url(self, url): # 发送请求,获取响应
    print(url)
    response = requests.get(url, headers=self.headers)
    return response.content.decode()

  def get_first_page_content_list(self, html_str): # 提取第一页的数据
    content_list = re.findall(r'<div class="j-r-list-c-desc">\s*<a href="/detail-.*" rel="external nofollow" rel="external nofollow" rel="external nofollow" >(.+?)</a>', html_str) # 非贪婪匹配
    return content_list

  def save_content_list(self, content_list):
    with open('neihan.txt', 'a', encoding='utf-8') as f:
      for content in content_list:
        f.write(json.dumps(content, ensure_ascii=False))
        f.write('\n') # 换行
      print('成功保存一页!')

  def run(self): # 实现主要逻辑
    for i in range(20): # 只爬取前20页数据
      # 1. 构造url
      # 2. 发送请求,获取响应
      html_str = self.pass_url(self.temp_url.format(i+1))
      # 3. 提取数据
      content_list = self.get_first_page_content_list(html_str)
      # 4. 保存
      self.save_content_list(content_list)

if __name__ == '__main__':
  neihan = NeihanSpider()
  neihan.run()
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。