python爬虫 爬取超清壁纸代码实例
简介
壁纸的选择其实很大程度上能看出电脑主人的内心世界,有的人喜欢风景,有的人喜欢星空,有的人喜欢美女,有的人喜欢动物。然而,终究有一天你已经产生审美疲劳了,但你下定决定要换壁纸的时候,又发现网上的壁纸要么分辨率低,要么带有水印。
壁纸的选择其实很大程度上能看出电脑主人的内心世界,有的人喜欢风景,有的人喜欢星空,有的人喜欢美女,有的人喜欢动物。然而,终究有一天你已经产生审美疲劳了,但你下定决定要换壁纸的时候,又发现网上的壁纸要么分辨率低,要么带有水印。
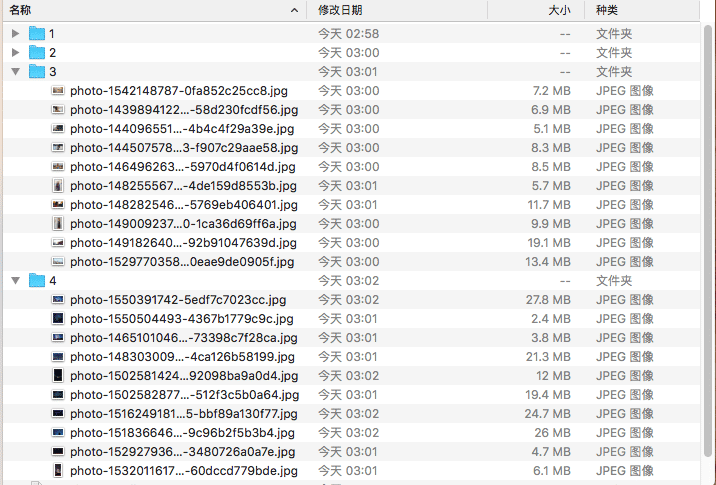
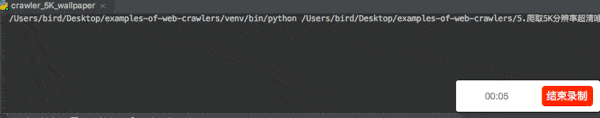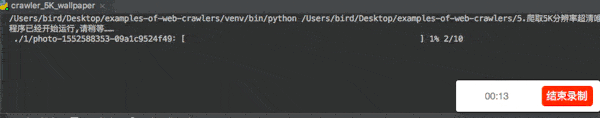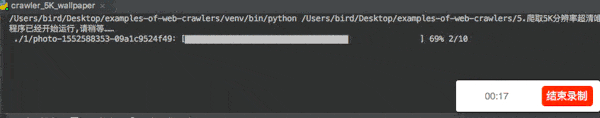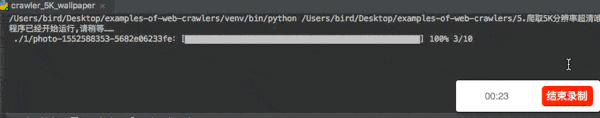
演示图片
完整源代码
'''
在学习过程中有什么不懂得可以加我的
python学习交流扣扣qun,934109170
群里有不错的学习教程、开发工具与电子书籍。
与你分享python企业当下人才需求及怎么从零基础学习好python,和学习什么内容。
'''
# -*- coding:utf-8 -*-
from requests import get
from filetype import guess
from os import rename
from os import makedirs
from os.path import exists
from json import loads
from contextlib import closing
# 文件下载器
def Down_load(file_url, file_full_name, now_photo_count, all_photo_count):
  headers = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36"}
  # 开始下载图片
  with closing(get(file_url, headers=headers, stream=True)) as response:
    chunk_size = 1024 # 单次请求最大值
    content_size = int(response.headers['content-length']) # 文件总大小
    data_count = 0 # 当前已传输的大小
    with open(file_full_name, "wb") as file:
      for data in response.iter_content(chunk_size=chunk_size):
        file.write(data)
        done_block = int((data_count / content_size) * 50)
        data_count = data_count + len(data)
        now_jd = (data_count / content_size) * 100
        print("\r %s:[%s%s] %d%% %d/%d" % (file_full_name, done_block * '█', ' ' * (50 - 1 - done_block), now_jd, now_photo_count, all_photo_count), end=" ")
  # 下载完图片后获取图片扩展名,并为其增加扩展名
  file_type = guess(file_full_name)
  rename(file_full_name, file_full_name + '.' + file_type.extension)
# 爬取不同类型图片
def crawler_photo(type_id, photo_count):
  # 最新 1, 最热 2, 女生 3, 星空 4
  if(type_id == 1):
    url = 'https://service.paper.meiyuan.in/api/v2/columns/flow/5c68ffb9463b7fbfe72b0db0?page=1&per_page=' + str(photo_count)
  elif(type_id == 2):
    url = 'https://service.paper.meiyuan.in/api/v2/columns/flow/5c69251c9b1c011c41bb97be?page=1&per_page=' + str(photo_count)
  elif(type_id == 3):
    url = 'https://service.paper.meiyuan.in/api/v2/columns/flow/5c81087e6aee28c541eefc26?page=1&per_page=' + str(photo_count)
  elif(type_id == 4):
    url = 'https://service.paper.meiyuan.in/api/v2/columns/flow/5c81f64c96fad8fe211f5367?page=1&per_page=' + str(photo_count)
  # 获取图片列表数据
  headers = {"User-Agent": "Mozilla/5.0 (Windows NT 6.1; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/63.0.3239.132 Safari/537.36"}
  respond = get(url, headers=headers)
  photo_data = loads(respond.content)
  # 已经下载的图片张数
  now_photo_count = 1
  # 所有图片张数
  all_photo_count = len(photo_data)
  # 开始下载并保存5K分辨率壁纸
  for photo in photo_data:
    # 创建一个文件夹存放我们下载的图片
    if not exists('./' + str(type_id)):
      makedirs('./' + str(type_id))
    # 准备下载的图片链接
    file_url = photo['urls']['raw']
    # 准备下载的图片名称,不包含扩展名
    file_name_only = file_url.split('/')
    file_name_only = file_name_only[len(file_name_only) -1]
    # 准备保存到本地的完整路径
    file_full_name = './' + str(type_id) + '/' + file_name_only
    # 开始下载图片
    Down_load(file_url, file_full_name, now_photo_count, all_photo_count)
    now_photo_count = now_photo_count + 1
if __name__ == '__main__':
  # 最新 1, 最热 2, 女生 3, 星空 4
  # 爬取类型为3的图片(女生),一共准备爬取20000张
  wall_paper_id = 1
  wall_paper_count = 10
  while(True):
    # 换行符
    print('\n\n')
    # 选择壁纸类型
    wall_paper_id = input("壁纸类型:最新壁纸 1, 最热壁纸 2, 女生壁纸 3, 星空壁纸 4\n请输入编号以便选择5K超清壁纸类型:")
    # 判断输入是否正确
    while(wall_paper_id != str(1) and wall_paper_id != str(2) and wall_paper_id != str(3) and wall_paper_id != str(4)):
      wall_paper_id = input("壁纸类型:最新壁纸 1, 最热壁纸 2, 女生壁纸 3, 星空壁纸 4\n请输入编号以便选择5K超清壁纸类型:")
    # 选择要下载的壁纸数量
    wall_paper_count = input("请输入要下载的5K超清壁纸的数量:")
    # 判断输入是否正确
    while(int(wall_paper_count) <= 0):
      wall_paper_count = input("请输入要下载的5K超清壁纸的数量:")
    # 开始爬取5K高清壁纸
    print("正在下载5K超清壁纸,请稍等……")
    crawler_photo(int(wall_paper_id), int(wall_paper_count))
    print('\n下载5K高清壁纸成功!')
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。