Python 合并多个TXT文件并统计词频的实现
需求是:针对三篇英文文章进行分析,计算出现次数最多的 10 个单词
逻辑很清晰简单,不算难, 使用 python 读取多个 txt 文件,将文件的内容写入新的 txt 中,然后对新 txt 文件进行词频统计,得到最终结果。
代码如下:(在Windows 10,Python 3.7.4环境下运行通过)
# coding=utf-8

import re
import os

# 获取源文件夹的路径下的所有文件
sourceFileDir = 'D:\\Python\\txt\\'
filenames = os.listdir(sourceFileDir)

# 打开当前目录下的 result.txt 文件,如果没有则创建
# 文件也可以是其他类型的格式,如 result.js
file = open('D:\\Python\\result.txt', 'w')

# 遍历文件
for filename in filenames:
 filepath = sourceFileDir+'\\'+filename
 # 遍历单个文件,读取行数,写入内容
 for line in open(filepath):
  file.writelines(line)
  file.write('\n')

# 关闭文件
file.close()


# 获取单词函数定义
def getTxt():
 txt = open('result.txt').read()
 txt = txt.lower()
 txt = txt.replace(''', '\'')
 # !"@#$%^&*()+,-./:;<=>?@[\\]_`~{|}
 for ch in '!"'@#$%^&*()+,-/:;<=>?@[\\]_`~{|}':
  txt.replace(ch, ' ')
  return txt

# 1.获取单词
hamletTxt = getTxt()

# 2.切割为列表格式,'' 兼容符号错误情况,只保留英文单词
txtArr = re.findall('[a-z\''A-Z]+', hamletTxt)

# 3.去除所有遍历统计
counts = {}
for word in txtArr:
 # 去掉一些常见无价值词
 forbinArr = ['a.', 'the', 'a', 'i']
 if word not in forbinArr:
  counts[word] = counts.get(word, 0) + 1

# 4.转换格式,方便打印,将字典转换为列表,次数按从大到小排序
countsList = list(counts.items())
countsList.sort(key=lambda x: x[1], reverse=True)

# 5. 输出结果
for i in range(10):
 word, count = countsList[i]
 print('{0:<10}{1:>5}'.format(word, count))
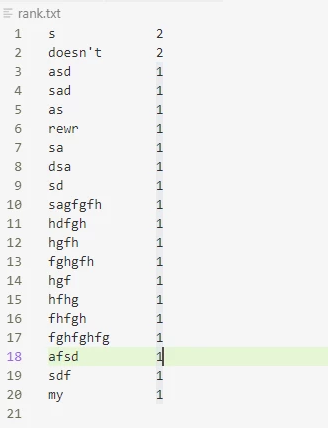
效果如下图:
另一种更简单的统计词频的方法:
# coding=utf-8
from collections import Counter

# words 为读取到的结果 list
words = ['a', 'b' ,'a', 'c', 'v', '4', ',', 'w', 'y', 'y', 'u', 'y', 'r', 't', 'w']
wordCounter = Counter(words)
print(wordCounter.most_common(10))

# output: [('y', 3), ('a', 2), ('w', 2), ('b', 1), ('c', 1), ('v', 1), ('4', 1), (',', 1), ('u', 1), ('r', 1)]
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。