python识别文字(基于tesseract)代码实例

yipeiwu_com7年前Python基础

这篇文章主要介绍了python识别文字(基于tesseract)代码实例,文中通过示例代码介绍的非常详细,对大家的学习或者工作具有一定的参考学习价值,需要的朋友可以参考下

Ubuntu版本:

1.tesseract-ocr安装

sudo apt-get install tesseract-ocr

2.pytesseract安装

sudo pip install pytesseract

3.Pillow 安装

sudo pip install pillow

开始写代码:

from PIL import Image
from pytesseract import pytesseract
image = Image.open('test.png')
code = pytesseract.image_to_string(image,lang='chi_sim')
print(code)

报错了:

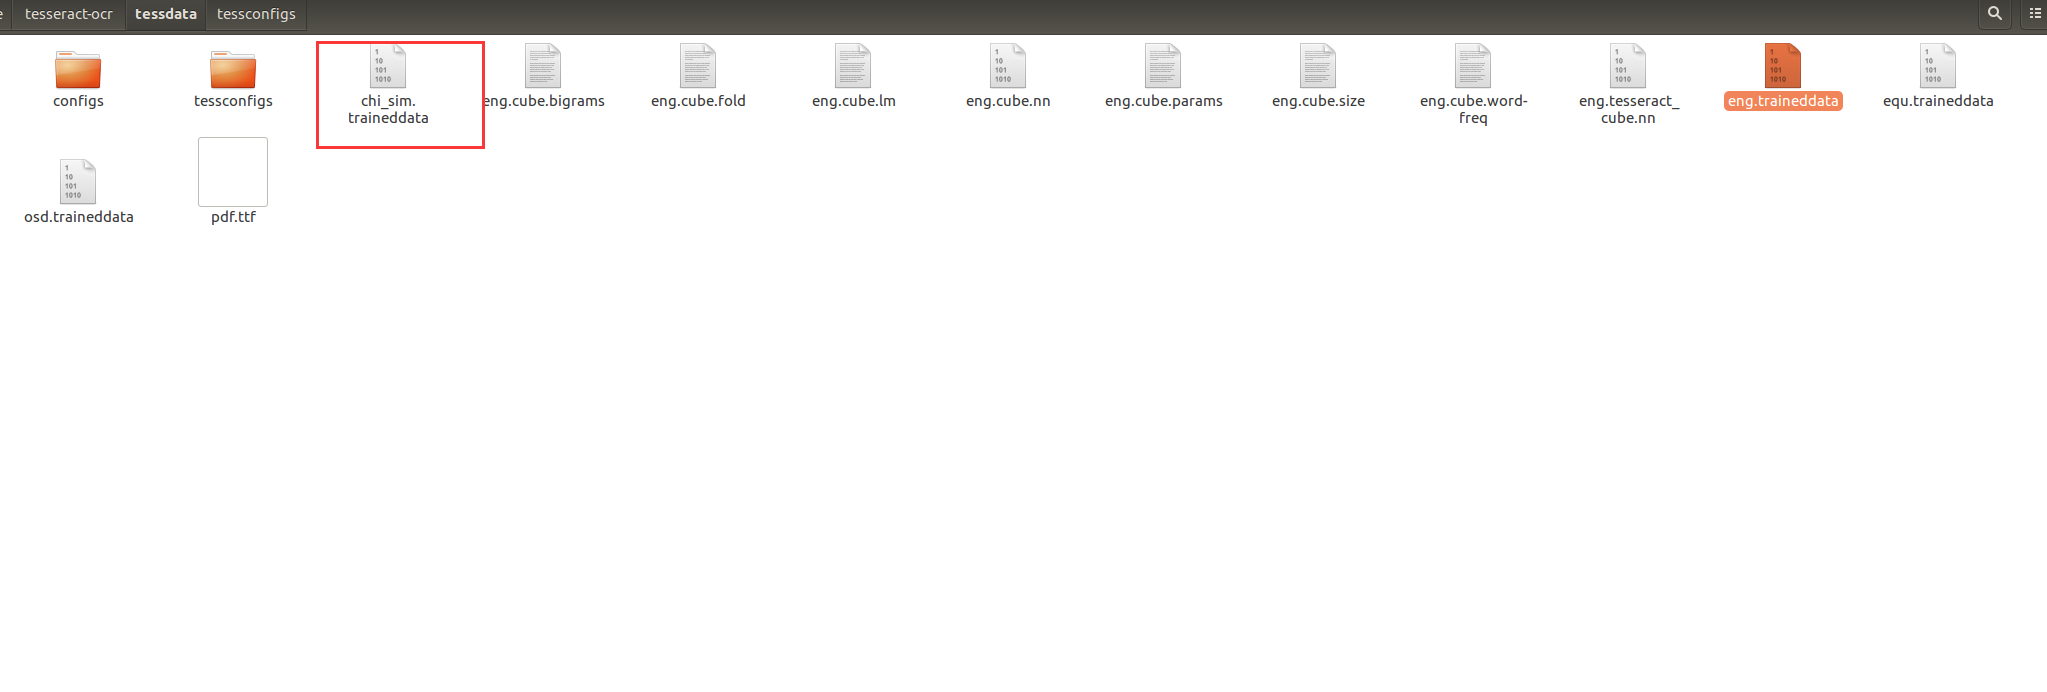
找到路径,发现没有chi_sim.traineddata这个训练包

# 安装训练数据(equ为数学公式包)
sudo apt-get install tesseract-ocr-eng tesseract-ocr-chi-sim tesseract-ocr-equ

安装之后就会有训练包了,可以正常运行。
英文识别正确率较高,中文就比较鸡肋了。
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。
相关文章

python 使用matplotlib 实现从文件中读取x,y坐标的可视化方法

python 使用matplotlib 实现从文件中读取x,y坐标的可视化方法

1. test.txt文件,数据以逗号分割,第一个数据为x坐标,第二个为y坐标,数据如下:1.1,2 2.1,2 3.1,3 4.1,5 40,38 42,41 43,42 2....

Python3生成手写体数字方法

Python3生成手写体数字方法

0.引言   平时上网干啥的基本上都会接触验证码,或者在机器学习学习过程中,大家或许会接触过手写体识别/验证码识别之类问题,会用到手写体的数据集;   自己尝试写了一个生成手写体图片的p...

Python实现多进程的四种方式

方式一: os.fork() # -*- coding:utf-8 -*- """ pid=os.fork() 1.只用在Unix系统中有效,Windows系统中无效 2.f...

Python中的pack和unpack的使用

不同类型的语言支持不同的数据类型,比如 Go 有 int32、int64、uint32、uint64 等不同的数据类型,这些类型占用的字节大小不同,而同样的数据类型在其他语言中比如 Py...

python用pickle模块实现“增删改查”的简易功能

pickle的作用: 1:pickle.dump(dict,file)把字典转为二进制存入文件. 2:pickle.load(file)把文件二进制内容转为字典 import pi...