Python爬虫运用正则表达式的方法和优缺点
前言
我看到最近几部电影很火,查了一下猫眼电影上的数据,发现还有个榜单,里面有各种经典和热映电影的排行榜,然后我觉得电影封面图还挺好看的,想着一张一张下载真是费时费力,于是突发奇想,好像可以用一下最近学的东西实现我的需求,学习了正则表达式之后,想着要感受一下它在爬虫里面的效果和优缺点。
目标:爬取Top100榜单上电影的封面图
Top100榜单规则:将猫眼电影库中的经典影片,按照评分和评分人数从高到低综合排序取前100名,每天上午10点更新。相关数据来源于“猫眼电影库”。
下面是我做的步骤:
(1)查看页面元素,找到包含图片的路径的代码段落
(2)分析图片在web上面的唯一属性,便于之后获取正确图片位置信息
(3)因为需要翻页,观察多个页面的URL变化
(4)综合以上几个点,编写合适的正则表达式
1、python 标准库中re模块提供了正则表达式的全部功能,直接引入;requests模块是http库,爬虫常用库,而urllib.requests 则是最后用到写入文件的函数
import re
import requests
import urllib.request
2、先接收URL地址的HTML页面,然后转化为str形式(正则表达式是匹配字符串),第一个pattern1缩小范围,抓取目标部分,result1接收匹配的结果,这时候所有封面图地址就在里面了
response = requests.get(url)
response = str(response.content)
patttern1 = '<dl class="board-wrapper">.+?<div class="pager-main">'
result1 = re.compile(pat).findall(response)
3、第二个正则,匹配图片的地址信息
pat2 = '<img data-src="https://(.+?\.jpg)'
photos = re.compile(pat1).findall(re1[0])
这时候爬取到100张图的信息,如下图:
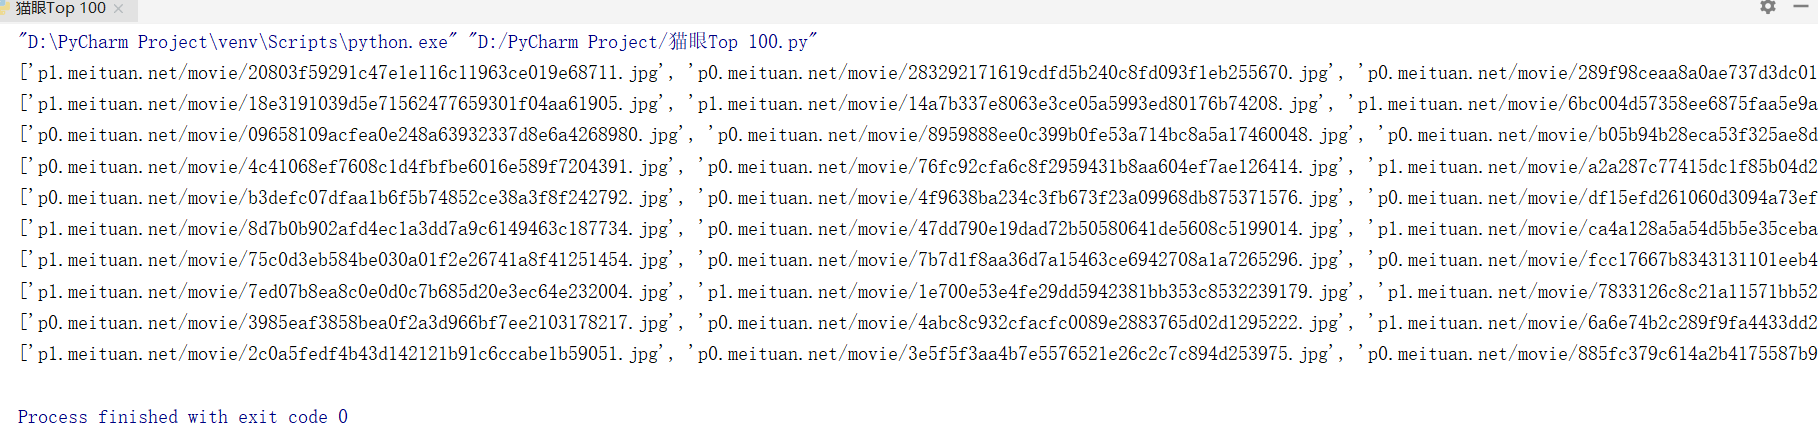
4、继续下一步,把每张图片命名好,需要正确的图片地址,避免重复
x = 1
for imgurl in name:
 imgname = 'D:/Top 100/'+str(i/10)+str(x)+'.jpg'
 imgurl = 'https://'+imgurl
 urllib.request.urlretrieve(imgurl,filename=imgname)
 x += 1
5、最后一步了,因为需要翻页爬取,所以加了一个循环,10页内容爬取下来
for i in range(0, 100, 10):
  url = 'http://maoyan.com/board/4?offset='+str(i)
  get_one_page(url, i)
  #定义函数,多次调用
相对来说,这是一个很简单的应用,也是自己学习之后的实践,在这个例子中,我是用到正则表达式来实现的,还有其他方法,而且可能简单,比如BeautifulSoup,XPath等方法,用在更加复杂的爬虫项目里面,需要的知识更多,方法更严谨,还需学习学习!
总结
以上就是这篇文章的全部内容了,希望本文的内容对大家的学习或者工作具有一定的参考学习价值,谢谢大家对【听图阁-专注于Python设计】的支持。