python实现的读取网页并分词功能示例
本文实例讲述了python实现的读取网页并分词功能。分享给大家供大家参考,具体如下:
这里使用分词使用最流行的分词包jieba,参考:https://github.com/fxsjy/jieba
或点击此处本站下载jieba库。
代码:
import requests
from bs4 import BeautifulSoup
import jieba
# 获取html
url = "http://finance.ifeng.com/a/20180328/16049779_0.shtml"
res = requests.get(url)
res.encoding = 'utf-8'
content = res.text
# 添加至bs4
soup = BeautifulSoup(content, 'html.parser')
div = soup.find(id = 'main_content')
# 写入文件
filename = 'news.txt'
with open(filename,'w',encoding='utf-8') as file_object:
  # <p>标签的处理
  for line in div.findChildren():
    file_object.write(line.get_text()+'\n')
# 使用分词工具
seg_list = jieba.cut("我来到北京清华大学", cut_all=True)
print("Full Mode: " + "/ ".join(seg_list)) # 全模式
seg_list = jieba.cut("我来到北京清华大学", cut_all=False)
print("Default Mode: " + "/ ".join(seg_list)) # 精确模式
seg_list = jieba.cut("他来到了网易杭研大厦") # 默认是精确模式
print(", ".join(seg_list))
with open(filename,'r',encoding='utf-8') as file_object:
  with open('cut_news.txt','w',encoding='utf-8') as file_cut_object:
    for line in file_object.readlines():
      seg_list = jieba.cut(line,cut_all=False)
      file_cut_object.write('/'.join(seg_list))
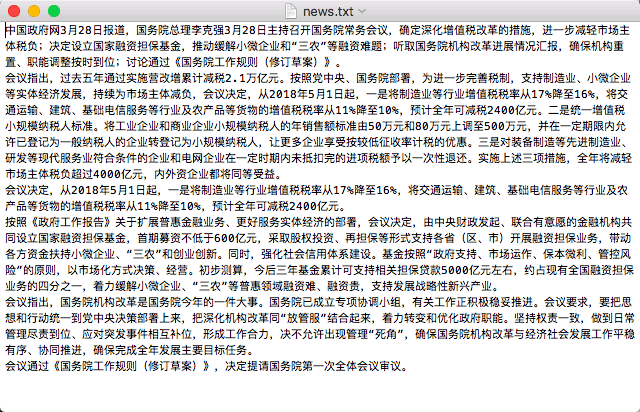
爬取结果:
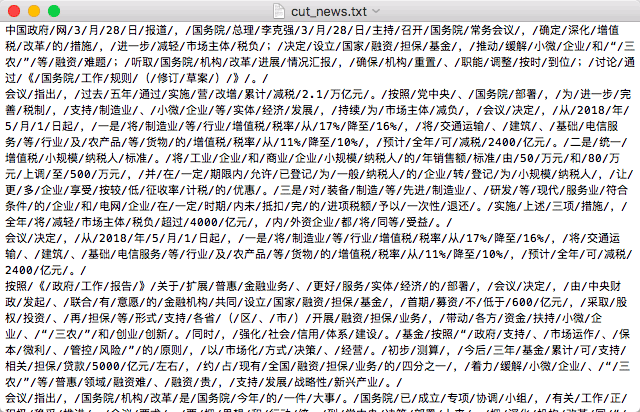
分词结果:
更多关于Python相关内容感兴趣的读者可查看本站专题:《Python数学运算技巧总结》、《Python数据结构与算法教程》、《Python函数使用技巧总结》、《Python字符串操作技巧汇总》、《Python入门与进阶经典教程》及《Python文件与目录操作技巧汇总》
希望本文所述对大家Python程序设计有所帮助。