Series和DataFrame使用简单入门
(1)、导入库
from pandas import Series,DataFrame
import pandas
import numpy
(2)、Series简单创建与使用
#Serires
obj = Series([4,7,-5,3]) #简单创建Serires
print(obj) #简单输出
print(obj.values) #输出值
print(obj.index)  #输出索引

obj2 = Series([4,7,-5,3], index=['d','b','a','c'])  #指定索引
print(obj2)   #简单输出
print(obj2.index)  #输出索引
print(obj2['a'])  #根据索引输出单个值
obj2['d']=6   #根据索引修改值
print(obj2['d'])  #输出
print(obj2[['d','a','c']]) #输出多个值
print(obj2[obj2 > 0])  #按条件输出
print('b' in obj2) #根据索引看数组里面是否有,返回True
print('e' in obj2) #返回False
(3)、根据字典创建Series
#根据字典创建Series
sdata = {'Oer':56,'asdgr':32,'rgg':89,'greg':44}
obj3 = Series(sdata)
print(obj3)
(4)、列表与字典进行匹配
#列表与字典进行匹配
sdata = {'Oer':56,'asdgr':32,'rgg':89,'greg':44}
states = ['Casfef','Oer','rgg','greg']
obj4 = Series(sdata, index = states)  #列表与字典进行匹配
print(obj4)
print(pd.isnull(obj4)) #查看数据是否为空
print(pd.notnull(obj4)) #查看数据是否非空
(5)、两个Serires相加
#两个Serires相加
obj1 = Series([3,7,-4,3], index=['q','b','a','c'])
obj2 = Series([4,7,-5,3], index=['d','b','a','g'])
print(obj1 + obj2) #两个Serires相加,具有共同索引的则相加,如果不是共同索引就置为NaN
(6)、修改索引的名字
#修改索引的名字
#obj = Series([4,7,-5,3], index=['d','b','a','g'])
#obj.index = ['Bob','Steve','Jeff','Ryan']
#print(obj.index)
(7)、dataframe的简单应用
#dataframe的简单应用
data = {'state': ['fergre', 'gerg', 'bhtr', 'hbtr'],
    'year': [2000, 2005, 2006, 2007],
    'pop' : [1.5,2.4,3.6,5.5]}
frame = DataFrame(data)   #根据字典创建DataFrame
frame2 = DataFrame(data, columns= ['state', 'pop', 'year'])   #指定列的排列顺序
frame3 = DataFrame(data, index= ['a','b','c','d'])   #指定行索引
(8)、获取DataFrame其中的一列(相当于Series)
#获取DataFrame其中的一列(相当于Series)
data = {'state': ['fergre', 'gerg', 'bhtr', 'hbtr'],
    'year': [2000, 2005, 2006, 2007],
    'pop' : [1.5,2.4,3.6,5.5]}
frame = DataFrame(data,index= ['q1','q2','q3','q4'])   #根据字典创建DataFrame
print(frame['year'])  #获取其中的一列
print(frame.loc['q2'])  #获取其中的一行
(9)、修改DataFrame中的值
#修改DataFrame中的值
data = {'state': ['fergre', 'gerg', 'bhtr', 'hbtr'],
    'year': [2000, 2005, 2006, 2007],
    'pop' : [1.5,2.4,3.6,5.5]}
frame = DataFrame(data,index= ['q1','q2','q3','q4'])   #根据字典创建DataFrame
frame['grg'] = numpy.arange(4) #修改某一列的值
val = Series([8.2,8.5,8.7], index=['q1','q3','q4'])   #修改指定列的值
frame['pop'] = val
print(frame)
(10)、输出DataFrame整体值
#输出DataFrame整体值
data = {'state': ['fergre', 'gerg', 'bhtr', 'hbtr'],
    'year': [2000, 2005, 2006, 2007],
    'pop' : [1.5,2.4,3.6,5.5]}
frame = DataFrame(data,index= ['q1','q2','q3','q4'])   #根据字典创建DataFrame
print(frame.values)
(11)、DataFrame的构造函数
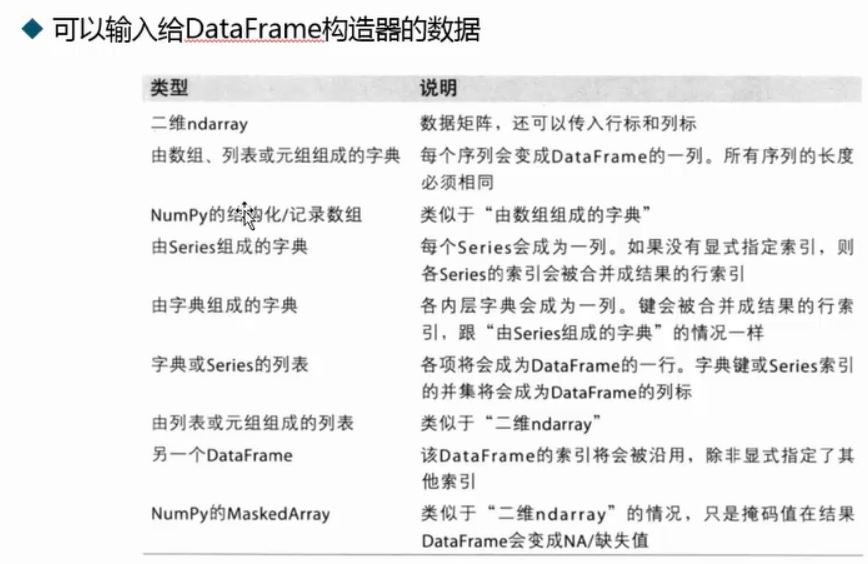
以上就是本文的全部内容,希望对大家的学习有所帮助,也希望大家多多支持【听图阁-专注于Python设计】。