基于MSELoss()与CrossEntropyLoss()的区别详解
基于pytorch来讲
MSELoss()多用于回归问题,也可以用于one_hotted编码形式,
CrossEntropyLoss()名字为交叉熵损失函数,不用于one_hotted编码形式
MSELoss()要求batch_x与batch_y的tensor都是FloatTensor类型
CrossEntropyLoss()要求batch_x为Float,batch_y为LongTensor类型
(1)CrossEntropyLoss() 举例说明:
比如二分类问题,最后一层输出的为2个值,比如下面的代码:
class CNN (nn.Module ) :
  def __init__ ( self , hidden_size1 , output_size , dropout_p) :
    super ( CNN , self ).__init__ ( )
    self.hidden_size1 = hidden_size1
    self.output_size = output_size
    self.dropout_p = dropout_p

    self.conv1 = nn.Conv1d ( 1,8,3,padding =1)
    self.fc1 = nn.Linear (8*500, self.hidden_size1 )
    self.out = nn.Linear (self.hidden_size1,self.output_size )


  def forward ( self , encoder_outputs ) :
    cnn_out = F.max_pool1d ( F.relu (self.conv1(encoder_outputs)),2)
    cnn_out = F.dropout ( cnn_out ,self.dropout_p) #加一个dropout
    cnn_out = cnn_out.view (-1,8*500)
    output_1 = torch.tanh ( self.fc1 ( cnn_out ) )
    output = self.out ( ouput_1)
    return output
最后的输出结果为:
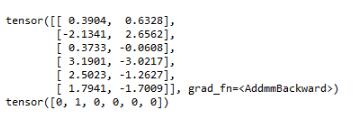
上面一个tensor为output结果,下面为target,没有使用one_hotted编码。
训练过程如下:
cnn_optimizer = torch.optim.SGD(cnn.parameters(),learning_rate,momentum=0.9,\
              weight_decay=1e-5)
criterion = nn.CrossEntropyLoss()

def train ( input_variable , target_variable , cnn , cnn_optimizer , criterion ) :
  cnn_output = cnn( input_variable )
  print(cnn_output)
  print(target_variable)
  loss = criterion ( cnn_output , target_variable)
  cnn_optimizer.zero_grad ()
  loss.backward( )
  cnn_optimizer.step( )
  #print('loss: ',loss.item())
  return loss.item() #返回损失
说明CrossEntropyLoss()是output两位为one_hotted编码形式,但target不是one_hotted编码形式。
(2)MSELoss() 举例说明:
网络结构不变,但是标签是one_hotted编码形式。下面的图仅做说明,网络结构不太对,出来的预测也不太对。

如果target不是one_hotted编码形式会报错,报的错误如下。

目前自己理解的两者的区别,就是这样的,至于多分类问题是不是也是样的有待考察。
以上这篇基于MSELoss()与CrossEntropyLoss()的区别详解就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。