在pytorch中对非叶节点的变量计算梯度实例
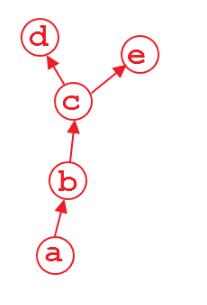
在pytorch中一般只对叶节点进行梯度计算,也就是下图中的d,e节点,而对非叶节点,也即是c,b节点则没有显式地去保留其中间计算过程中的梯度(因为一般来说只有叶节点才需要去更新),这样可以节省很大部分的显存,但是在调试过程中,有时候我们需要对中间变量梯度进行监控,以确保网络的有效性,这个时候我们需要打印出非叶节点的梯度,为了实现这个目的,我们可以通过两种手段进行。
注册hook函数
Tensor.register_hook[2] 可以注册一个反向梯度传导时的hook函数,这个hook函数将会在每次计算 关于该张量  的时候 被调用,经常用于调试的时候打印出非叶节点梯度。当然,通过这个手段,你也可以自定义某一层的梯度更新方法。[3] 具体到这里的打印非叶节点的梯度,代码如:
def hook_y(grad):
 print(grad)

x = Variable(torch.ones(2, 2), requires_grad=True)
y = x + 2
z = y * y * 3

y.register_hook(hook_y)

out = z.mean()
out.backward()
输出如:
tensor([[4.5000, 4.5000],
  [4.5000, 4.5000]])
retain_grad()
Tensor.retain_grad()显式地保存非叶节点的梯度,当然代价就是会增加显存的消耗,而用hook函数的方法则是在反向计算时直接打印,因此不会增加显存消耗,但是使用起来retain_grad()要比hook函数方便一些。代码如:
x = Variable(torch.ones(2, 2), requires_grad=True)
y = x + 2
y.retain_grad()
z = y * y * 3
out = z.mean()
out.backward()
print(y.grad)
输出如:
tensor([[4.5000, 4.5000],
  [4.5000, 4.5000]])
以上这篇在pytorch中对非叶节点的变量计算梯度实例就是小编分享给大家的全部内容了,希望能给大家一个参考,也希望大家多多支持【听图阁-专注于Python设计】。